

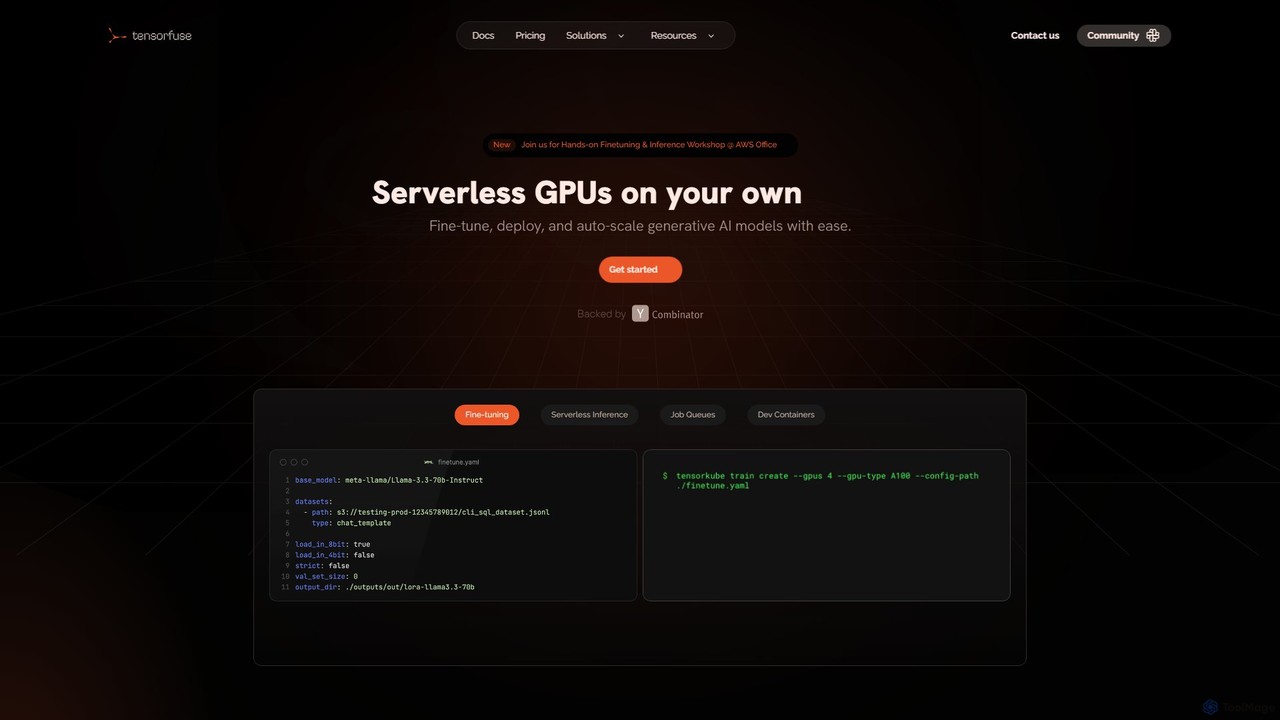
Tensorfuse Overview
Tensorfuse cung cấp một nền tảng mạnh mẽ cho các nhà phát triển và tổ chức để quản lý GPU không máy chủ trực tiếp trên cơ sở hạ tầng đám mây AWS của riêng họ. Nó được thiết kế để hợp lý hóa toàn bộ vòng đời của các mô hình AI tạo sinh, từ tinh chỉnh và thử nghiệm đến triển khai và tự động mở rộng quy mô trong sản xuất. Bằng cách trừu tượng hóa sự phức tạp của Kubernetes, Docker và việc cung cấp cơ sở hạ tầng, Tensorfuse cho phép các nhóm tập trung vào việc xây dựng các ứng dụng AI, giảm đáng kể thời gian đưa sản phẩm ra thị trường và chi phí vận hành.
Nền tảng này được xây dựng để cung cấp những gì tốt nhất của cả hai thế giới: sự đơn giản của kiến trúc không máy chủ và sự an toàn, kiểm soát khi chạy trên đám mây riêng của bạn. Điều này có nghĩa là dữ liệu độc quyền và trọng số mô hình của bạn không bao giờ rời khỏi các bucket S3 riêng tư của bạn, đảm bảo an ninh và tuân thủ tối đa. Tensorfuse được thiết kế để mang lại hiệu quả, với một runtime container được tối ưu hóa cho phép khởi động nguội nhanh chóng cho các khối lượng công việc GPU nặng, cho phép các dịch vụ mở rộng từ con số không trong vài giây.
Cách sử dụng Tensorfuse
Bắt đầu với Tensorfuse được thiết kế là một quy trình đơn giản:
- Đăng ký & Kết nối AWS: Bắt đầu bằng cách đăng ký một gói (bao gồm cả bậc 'Hacker' miễn phí) và kết nối tài khoản AWS của bạn. Tensorfuse sau đó sẽ thiết lập các tài nguyên cần thiết trong môi trường đám mây của bạn.
- Sử dụng Vùng chứa Phát triển để Thử nghiệm: Kết nối IDE cục bộ của bạn (như VS Code) trực tiếp với GPU đám mây bằng cách sử dụng Vùng chứa Phát triển của Tensorfuse. Điều này loại bỏ nhu cầu về SSH, sao chép mã và quản lý phụ thuộc. Mọi thay đổi đối với mã cục bộ của bạn đều được đồng bộ hóa ngay lập tức, cho phép thử nghiệm thời gian thực nhanh chóng.
- Tinh chỉnh Mô hình: Sử dụng các thư viện đào tạo phổ biến như Axolotl, Unsloth hoặc Hugging Face để tinh chỉnh các mô hình nguồn mở trên bộ dữ liệu độc quyền của bạn. Bạn cũng có thể viết các vòng lặp đào tạo tùy chỉnh. Nền tảng sẽ xử lý việc cung cấp và quản lý GPU cơ bản.
- Triển khai để Suy luận: Triển khai các mô hình đã được đào tạo hoặc được đào tạo trước của bạn dưới dạng các điểm cuối không máy chủ. Các điểm cuối này tự động mở rộng quy mô dựa trên lưu lượng truy cập đến, từ con số không để xử lý đồng thời cao, đảm bảo hiệu quả chi phí và hiệu suất. Các mô hình có thể được hiển thị dưới dạng các API tương thích với OpenAI.
- Quản lý bằng Hàng đợi Công việc: Đối với các tác vụ không đồng bộ như xử lý hàng loạt hoặc suy luận ngoại tuyến, hãy sử dụng tính năng Hàng đợi Công việc. Bạn có thể xếp hàng công việc theo chương trình, xác định các tham số mở rộng tối thiểu và tối đa để phân bổ tài nguyên hiệu quả và giám sát trạng thái của chúng thông qua một lệnh CLI đơn giản.
Tính năng chính của Tensorfuse
- Suy luận Không máy chủ: Tự động mở rộng quy mô triển khai GPU để đáp ứng lưu lượng truy cập, với khả năng khởi động nguội nhanh (khởi động container trong vài giây) và khả năng thu nhỏ về không để tiết kiệm chi phí.
- Tinh chỉnh Hiệu quả: Tinh chỉnh các mô hình một cách an toàn trên dữ liệu riêng tư của bạn bằng S3 trên đám mây của bạn. Nó cung cấp tích hợp linh hoạt với các framework phổ biến như Axolotl và Huggingface.
- Hàng đợi Công việc: Triển khai và xếp hàng công việc theo chương trình để xử lý hàng loạt, với việc phân bổ tài nguyên hiệu quả và kiểm soát chi phí thông qua việc mở rộng quy mô có thể cấu hình.
- Vùng chứa Phát triển: Kết nối mã cục bộ với GPU đám mây mà không cần SSH để phát triển và thử nghiệm lặp đi lặp lại nhanh chóng trực tiếp từ IDE yêu thích của bạn.
- Suy luận Đa LoRA: Hỗ trợ sẵn có để đào tạo và hoán đổi nóng hàng nghìn bộ điều hợp LoRA trên một GPU duy nhất, tối đa hóa việc sử dụng phần cứng và giảm chi phí suy luận.
- Hỗ trợ Phần cứng Rộng rãi: Chạy khối lượng công việc trên nhiều loại phần cứng, bao gồm GPU NVIDIA (A10G, A100, H100), chip AWS Trainium/Inferentia, TPU và FPGA.
- Bảo mật Đám mây Riêng: Tất cả dữ liệu, bộ dữ liệu và trọng số mô hình vẫn nằm trong các bucket S3 riêng tư của AWS, đảm bảo toàn quyền kiểm soát và bảo mật.
Các trường hợp sử dụng Tensorfuse
Tensorfuse lý tưởng cho một loạt các ứng dụng AI/ML:
- Các công ty khởi nghiệp và nhóm nhỏ: Nhanh chóng xây dựng và triển khai các tính năng do AI cung cấp mà không cần đội ngũ DevOps chuyên dụng, chuyển từ ý tưởng sang sản xuất nhanh hơn 20 lần.
- Suy luận Quy mô lớn: Phục vụ các mô hình AI tạo sinh cho các ứng dụng có lưu lượng truy cập đột biến hoặc không thể đoán trước, chỉ trả tiền cho lượng tính toán bạn sử dụng.
- Tinh chỉnh Mô hình Tùy chỉnh: Các công ty có thể tinh chỉnh các mô hình cơ sở như Llama hoặc Mistral trên dữ liệu độc quyền của họ để tạo ra các mô hình chuyên biệt, hiệu suất cao cho các nhu cầu kinh doanh cụ thể.
- Khối lượng công việc Xử lý Hàng loạt: Chạy hiệu quả các tác vụ không thời gian thực như phân tích dữ liệu, tạo báo cáo hoặc suy luận ngoại tuyến quy mô lớn bằng hệ thống hàng đợi công việc tiết kiệm chi phí.
- Nghiên cứu và Thử nghiệm ML: Các nhà nghiên cứu và kỹ sư ML có thể sử dụng Vùng chứa Phát triển để nhanh chóng lặp lại các mô hình mà không cần chờ thiết lập cơ sở hạ tầng.
Ưu điểm của Tensorfuse
Người dùng chọn Tensorfuse vì những lợi ích đáng kể của nó, bao gồm việc giảm 30% chi tiêu cho GPU đám mây và thời gian sản xuất nhanh hơn 20 lần. Nó loại bỏ nhu cầu về các giải pháp DevOps phức tạp, tự quản lý, giải phóng tài nguyên kỹ thuật. Nền tảng này cung cấp hiệu suất và khả năng mở rộng của một dịch vụ được quản lý với sự an toàn và lợi ích về chi phí khi chạy trên đám mây của riêng bạn. Các lời chứng thực nhấn mạnh đội ngũ hỗ trợ đặc biệt và phản ứng nhanh, hỗ trợ di chuyển và các vấn đề đang diễn ra, giúp quá trình tham gia trở nên suôn sẻ và hiệu quả.
Giá cả và gói dịch vụ
Tensorfuse cung cấp một cấu trúc giá theo cấp để phù hợp với các nhu cầu khác nhau:
- Hacker (Miễn phí): Dành cho các nhà phát triển độc lập và các dự án phụ. Bao gồm 100 Giờ GPU được Quản lý (MGH), Suy luận Không máy chủ, Vùng chứa Phát triển và hỗ trợ cộng đồng.
- Starter ($249/tháng): Dành cho các nhóm nhỏ. Bao gồm 2.000 MGH, tất cả các tính năng của Hacker, cộng với Tinh chỉnh, GitHub Actions, Tên miền Tùy chỉnh và hỗ trợ Slack riêng. Có sẵn bản dùng thử miễn phí 14 ngày.
- Growth ($799/tháng): Dành cho các công ty khởi nghiệp đang phát triển. Bao gồm 5.000 MGH, tất cả các tính năng của Starter, cộng với Công việc Hàng loạt & Hàng đợi Công việc, Môi trường, suy luận Đa LoRA và hỗ trợ cao cấp. Có sẵn bản dùng thử miễn phí 14 ngày.
- Enterprise (Tùy chỉnh): Dành cho các tổ chức lớn cần các tính năng nâng cao. Bao gồm MGH tùy chỉnh với chiết khấu theo số lượng, tất cả các tính năng của Growth, cộng với Kiểm soát Truy cập Dựa trên Vai trò (RBAC), SSO, bảo mật cấp doanh nghiệp (SOC2, HIPAA) và hỗ trợ kỹ thuật chuyên dụng.
- Ưu đãi cho Startup: Các công ty khởi nghiệp giai đoạn đầu với nguồn vốn dưới 500 nghìn đô la có thể đủ điều kiện nhận 10.000 giờ quản lý tính toán GPU miễn phí trong 6 tháng.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 10.1K
- 2026-1: 5.4K
- 2026-2: 4.2K
- 2026-3: 4.9K
- 2026-4: 5.3K
- 2026-5: 6.7K
Geography
Top 5 countries / regions
- 🇺🇸Hoa Kỳ38.2%
- 🇻🇳Việt Nam36.6%
- 🇮🇳Ấn Độ25.2%
Top keywords
| Keyword | Cost per click |
|---|---|
| aws serverless gpu | $0.00 |
| brew install aws cli | $4.38 |
| llama.cpp serverless | $0.00 |
| llm inference servers compared: vllm vs tgi vs sglang vs triton | $0.00 |
| tensorfuse | $18.26 |
Tensorfuse Alternatives

Baseten
Baseten là một nền tảng suy luận cấp sản xuất để triển khai, mở rộng và quản lý các mô hình AI. Nó cung cấp thời gian chạy hiệu suất cao, quy trình làm việc liền mạch cho nhà phát triển và các tùy chọn triển khai linh hoạt (đám mây, tự lưu trữ, lai). Lý tưởng cho các đội kỹ thuật và ML xây dựng các ứng dụng AI quan trọng.
Triển khai
Hopsworks
Hopsworks là một AI Lakehouse thời gian thực và là Kho tính năng (Feature Store) tiên tiến nhất trong ngành. Nó được thiết kế cho MLOps, hợp nhất dữ liệu và tính toán để xây dựng và vận hành các hệ thống AI thời gian thực, đáng tin cậy. Nó hỗ trợ mọi framework, đám mây hoặc môi trường tại chỗ, cho phép phát triển mô hình nhanh hơn và giảm chi phí đáng kể.
Cơ sở dữ liệu
Runpod
Runpod là một nền tảng đám mây được thiết kế cho AI và học máy, cung cấp khả năng tính toán GPU có thể mở rộng để triển khai, huấn luyện và chạy các mô hình AI. Nó cung cấp GPU không máy chủ, các mẫu dựng sẵn và giá cả hiệu quả về chi phí để đơn giản hóa toàn bộ quy trình phát triển AI, từ ý tưởng đến sản xuất.
Học máy
Nebius
Nebius là một nền tảng đám mây hiệu suất cao được thiết kế đặc biệt cho AI và học máy. Nền tảng này cung cấp quyền truy cập vào các GPU NVIDIA mới nhất, các cụm có thể mở rộng với mạng InfiniBand và các dịch vụ được quản lý hoàn toàn như Kubernetes và Slurm, cho phép đào tạo, tinh chỉnh và suy luận mô hình AI liền mạch ở mọi quy mô.
Học máy
dstack
dstack là một trình điều phối container mã nguồn mở được thiết kế cho các nhóm AI và ML. Nó đơn giản hóa việc điều phối khối lượng công việc và tối đa hóa việc sử dụng GPU trên bất kỳ nhà cung cấp đám mây, cụm tại chỗ hoặc phần cứng tăng tốc nào. Nó cung cấp một lớp tính toán thống nhất, hợp lý hóa việc phát triển, đào tạo và triển khai mô hình.
Điều phốiTensorfuse Categories
Tensorfuse Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Baseten
Baseten là một nền tảng suy luận cấp sản xuất để triển khai, mở rộng và quản lý các mô hình AI. Nó cung cấp thời gian chạy hiệu suất cao, quy trình làm việc liền mạch cho nhà phát triển và các tùy chọn triển khai linh hoạt (đám mây, tự lưu trữ, lai). Lý tưởng cho các đội kỹ thuật và ML xây dựng các ứng dụng AI quan trọng.
Triển khaiRunpod
Runpod là một nền tảng đám mây được thiết kế cho AI và học máy, cung cấp khả năng tính toán GPU có thể mở rộng để triển khai, huấn luyện và chạy các mô hình AI. Nó cung cấp GPU không máy chủ, các mẫu dựng sẵn và giá cả hiệu quả về chi phí để đơn giản hóa toàn bộ quy trình phát triển AI, từ ý tưởng đến sản xuất.
Học máyNebius
Nebius là một nền tảng đám mây hiệu suất cao được thiết kế đặc biệt cho AI và học máy. Nền tảng này cung cấp quyền truy cập vào các GPU NVIDIA mới nhất, các cụm có thể mở rộng với mạng InfiniBand và các dịch vụ được quản lý hoàn toàn như Kubernetes và Slurm, cho phép đào tạo, tinh chỉnh và suy luận mô hình AI liền mạch ở mọi quy mô.
Học máydstack
dstack là một trình điều phối container mã nguồn mở được thiết kế cho các nhóm AI và ML. Nó đơn giản hóa việc điều phối khối lượng công việc và tối đa hóa việc sử dụng GPU trên bất kỳ nhà cung cấp đám mây, cụm tại chỗ hoặc phần cứng tăng tốc nào. Nó cung cấp một lớp tính toán thống nhất, hợp lý hóa việc phát triển, đào tạo và triển khai mô hình.
Điều phối
GPUX
GPUX là một nền tảng đám mây GPU phi tập trung và không máy chủ dành cho việc suy luận mô hình AI nhanh chóng và giá cả phải chăng. Nó cho phép các nhà phát triển chạy mô hình qua API và chủ sở hữu GPU kiếm tiền bằng cách đóng góp phần cứng của họ vào mạng P2P.
Triển khai mô hình
CircleCI
CircleCI là một nền tảng tích hợp liên tục và phân phối liên tục (CI/CD) hàng đầu giúp tự động hóa quy trình phát triển phần mềm. Nó cho phép các nhóm kỹ thuật xây dựng, kiểm thử và triển khai mã một cách nhanh chóng, đáng tin cậy và ở quy mô lớn, tăng năng suất và sự tự tin trong mỗi lần phát hành.
Quản lý Hạ tầng
Together AI
Together AI là một nền tảng đám mây hàng đầu dành cho các nhà phát triển, cung cấp cơ sở hạ tầng nhanh chóng, tiết kiệm chi phí để chạy, tinh chỉnh và huấn luyện các mô hình AI tạo sinh mã nguồn mở. Nền tảng này cung cấp một thư viện phong phú với hơn 200 mô hình, API suy luận không máy chủ, khả năng tinh chỉnh tùy chỉnh và các cụm GPU chuyên dụng, tạo ra một giải pháp toàn diện để xây dựng và mở rộng các ứng dụng AI.
Cơ sở hạ tầng GPU
ComfyOnline
Một nền tảng dựa trên đám mây để chạy quy trình làm việc ComfyUI trực tuyến mà không cần phần cứng đắt tiền. Nó cung cấp một môi trường không máy chủ, triển khai API chỉ bằng một cú nhấp chuột cho các ứng dụng AI và quyền truy cập trả tiền theo mức sử dụng vào các GPU hiệu suất cao như H100 và A100. Nó đơn giản hóa toàn bộ quy trình từ tạo quy trình làm việc đến triển khai có thể mở rộng.
API và Cơ sở hạ tầng
Beam
Beam là một nền tảng đám mây không máy chủ được thiết kế cho các nhà phát triển để chạy, mở rộng quy mô và triển khai các mô hình và ứng dụng AI/ML trên GPU một cách dễ dàng. Nền tảng này cung cấp khả năng tự động mở rộng quy mô tức thì, thanh toán theo giây và quy trình làm việc được tối ưu hóa, cho phép bạn chuyển từ mã nguồn thành một API có khả năng mở rộng trong vài phút mà không cần quản lý cơ sở hạ tầng phức tạp.
Học máy
Addepto
Addepto là một công ty tư vấn Big Data và phát triển AI hàng đầu, cung cấp cho các doanh nghiệp các giải pháp AI tùy chỉnh. Họ chuyên về khoa học dữ liệu, học máy, MLOps và chiến lược AI tạo sinh, giúp khách hàng biến dữ liệu phức tạp thành thông tin chi tiết hữu ích và lợi thế cạnh tranh. Addepto cung cấp các dịch vụ toàn diện, từ tư vấn ban đầu và chiến lược đến phát triển, triển khai và hỗ trợ liên tục, đảm bảo các giải pháp phù hợp mang lại kết quả kinh doanh hữu hình.
Tư vấn
ComfyDeploy
ComfyDeploy là một nền tảng đám mây dành cho các nhóm để xây dựng, chia sẻ và mở rộng quy trình làm việc của ComfyUI. Nó cho phép triển khai API sẵn sàng cho sản xuất chỉ bằng một cú nhấp chuột, cung cấp cơ sở hạ tầng GPU tự động co giãn và giao diện đơn giản hóa cho người dùng không chuyên về kỹ thuật. Hợp tác liền mạch, quản lý các nút và mô hình tùy chỉnh, và biến các quy trình sáng tạo phức tạp thành các ứng dụng có thể mở rộng mà không tốn chi phí kỹ thuật.
Triển khai mô hình
Release.ai
Release.ai là một nền tảng cấp doanh nghiệp dành cho các nhà phát triển để dễ dàng triển khai, quản lý và mở rộng các mô hình AI hiệu suất cao. Nền tảng này cung cấp độ trễ suy luận dưới 100ms, tự động mở rộng liền mạch, bảo mật mạnh mẽ và một thư viện lớn các mô hình được tối ưu hóa sẵn, cho phép tích hợp nhanh chóng vào bất kỳ quy trình phát triển nào chỉ với vài dòng mã.
Nền tảng dưới dạng dịch vụ (PaaS)
LastMile AI
LastMile AI là một nền tảng dành cho nhà phát triển cấp doanh nghiệp để kiểm thử, đánh giá và giám sát các ứng dụng AI tạo sinh. Nền tảng cung cấp các công cụ như AutoEval để tinh chỉnh bộ đánh giá tùy chỉnh, tạo dữ liệu tổng hợp và giám sát thời gian thực nhằm đảm bảo hệ thống AI đáng tin cậy và sẵn sàng cho sản xuất.
Đánh giá Mô hình
Jyek
Jyek là một nền tảng AI agent hiểu mục tiêu, tạo kế hoạch thực thi, sử dụng công cụ và cung cấp kết quả có thể xác minh cho các tác vụ phức tạp nhiều bước.
Tự động hóa
MonsterAPI
MonsterAPI là một nền tảng tập trung vào nhà phát triển giúp đơn giản hóa việc tinh chỉnh và triển khai các mô hình AI tạo sinh mã nguồn mở. Nền tảng này cung cấp một giao diện trò chuyện không cần mã, MonsterGPT, để quản lý các tác vụ phức tạp, hỗ trợ các mô hình như Llama, SDXL và Whisper. Nền tảng cung cấp các điểm cuối API có thể mở rộng và cơ sở hạ tầng GPU cấp doanh nghiệp với chi phí và thời gian chỉ bằng một phần nhỏ so với thông thường, giúp mọi nhà phát triển đều có thể tiếp cận AI tiên tiến.
Nền tảng dưới dạng dịch vụ (PaaS)
Tensorfuse Comments (0)
Sign in to comment.
Đăng nhậpNo comments yet.