
Unsloth Overview
Unsloth là một thư viện AI mã nguồn mở mang tính cách mạng được thiết kế để giải quyết hai trong số những thách thức lớn nhất trong việc tùy chỉnh Mô hình Ngôn ngữ Lớn (LLM): tốc độ huấn luyện và mức tiêu thụ bộ nhớ. Được phát triển bởi một đội ngũ tận tâm, Unsloth định nghĩa lại hiệu quả của việc tinh chỉnh bằng cách sử dụng các tối ưu hóa toán học được suy ra thủ công và các nhân GPU được viết tay. Cách tiếp cận sáng tạo này cho phép các nhà phát triển, nhà nghiên cứu và doanh nghiệp huấn luyện các mô hình như Llama, Mistral và Gemma nhanh hơn tới 30 lần so với các phương pháp tiêu chuẩn như Flash Attention 2, và với mức giảm đáng kinh ngạc 90% trong việc sử dụng bộ nhớ. Điều này có nghĩa là các tác vụ từng mất một tháng giờ đây có thể được hoàn thành chỉ trong 24 giờ, và các mô hình mạnh mẽ có thể được tinh chỉnh trên một GPU cấp tiêu dùng duy nhất.
Phép màu cốt lõi của Unsloth nằm ở sự tối ưu hóa sâu ở cấp độ phần cứng. Thay vì dựa vào các thư viện cấp cao chung chung, những người tạo ra Unsloth đã quay trở lại các nguyên tắc đầu tiên, viết lại các bước tính toán nặng nề nhất của quá trình huấn luyện để tối đa hóa hiệu quả của GPU. Điều này không chỉ dẫn đến việc huấn luyện nhanh hơn mà còn tốc độ suy luận nhanh hơn đáng kể (lên đến 2 lần), cho phép triển khai các mô hình đã được tinh chỉnh nhanh hơn. Unsloth được thiết kế cho khả năng mở rộng, hoạt động đặc biệt tốt trên một GPU, hệ thống đa GPU và thậm chí cả các cụm đa nút cho các tác vụ cấp doanh nghiệp.
Cách sử dụng Unsloth
Việc sử dụng Unsloth được thiết kế đơn giản cho bất kỳ ai quen thuộc với hệ sinh thái Python và Hugging Face. Quá trình này thường bao gồm các bước sau:
- Cài đặt: Cài đặt thư viện Unsloth vào môi trường Python của bạn, thường bằng một lệnh pip đơn giản. Thư viện có sẵn dưới dạng phần mềm miễn phí mã nguồn mở.
- Nhập và Tải mô hình: Trong tập lệnh huấn luyện của bạn, nhập `FastLanguageModel` từ Unsloth. Thay vì tải mô hình trực tiếp từ `transformers` của Hugging Face, bạn sử dụng hàm của Unsloth để tải mô hình cơ sở. Hàm này tự động áp dụng tất cả các bản vá hiệu suất và tối ưu hóa cần thiết. Bạn có thể chỉ định tên mô hình (ví dụ: 'unsloth/llama-3-8b-Instruct-bnb-4bit') và kiểu dữ liệu (ví dụ: lượng tử hóa 4-bit) trong bước này.
- Thêm Bộ điều hợp LoRA: Unsloth đơn giản hóa quá trình thêm bộ điều hợp Thích ứng Hạng thấp (LoRA) vào mô hình. Bạn có thể cấu hình các tham số LoRA (như `r`, `lora_alpha`, `target_modules`) và áp dụng chúng vào mô hình chỉ bằng một dòng mã.
- Chuẩn bị dữ liệu: Chuẩn bị tập dữ liệu huấn luyện của bạn như cách bạn thường làm cho một tác vụ tinh chỉnh của Hugging Face.
- Huấn luyện: Sử dụng `SFTTrainer` của Hugging Face hoặc một lớp huấn luyện tương tự, truyền vào mô hình đã được tối ưu hóa bởi Unsloth, tập dữ liệu và các đối số huấn luyện của bạn. Unsloth tích hợp liền mạch với quy trình làm việc này, tự động tăng tốc các bước lan truyền ngược và tối ưu hóa.
- Suy luận: Sau khi huấn luyện hoàn tất, bạn có thể sử dụng mô hình đã được tinh chỉnh để suy luận, quá trình này cũng được hưởng lợi từ các cải tiến tốc độ của Unsloth.
Tính năng chính của Unsloth
- Tăng tốc độ cực đại: Huấn luyện và tinh chỉnh nhanh hơn tới 30 lần so với các triển khai tiêu chuẩn như Flash Attention 2.
- Giảm bộ nhớ lớn: Giảm tới 90% việc sử dụng VRAM, cho phép tinh chỉnh các mô hình lớn trên GPU cấp tiêu dùng (như Tesla T4 hoặc thậm chí dòng GeForce RTX).
- Nhân GPU viết tay: Các phép toán cốt lõi được tối ưu hóa thủ công để đạt hiệu suất phần cứng tối đa, vượt qua khả năng của các thư viện chung.
- Hỗ trợ mô hình rộng rãi: Hỗ trợ nguyên bản một loạt các LLM mã nguồn mở phổ biến, bao gồm Llama 1/2/3, Mistral, Gemma, Qwen, DeepSeek, v.v.
- Hỗ trợ lượng tử hóa: Hỗ trợ đầy đủ cho việc tinh chỉnh LoRA 4-bit và 16-bit, giúp việc huấn luyện càng tiết kiệm bộ nhớ hơn.
- Khả năng mở rộng: Được tối ưu hóa cho các cấu hình một GPU, đa GPU (lên đến 8) và đa nút (Enterprise).
- Suy luận nhanh hơn: Cung cấp tốc độ suy luận nhanh hơn tới 2 lần sau khi huấn luyện, giúp việc triển khai mô hình hiệu quả hơn.
- Cải thiện độ chính xác: Gói Enterprise cung cấp các tính năng có thể tăng độ chính xác của mô hình lên đến 30% trên một số tác vụ nhất định.
Các trường hợp sử dụng Unsloth
Unsloth là một công cụ đa năng cho bất kỳ ai làm việc với LLM:
- Các công ty khởi nghiệp AI: Xây dựng và lặp lại các mô hình tùy chỉnh, chuyên biệt cho các ứng dụng thích hợp mà không phải chịu chi phí điện toán đám mây khổng lồ.
- Các nhà nghiên cứu học thuật: Tăng tốc chu kỳ nghiên cứu và chạy nhiều thử nghiệm hơn với ngân sách phần cứng đại học hạn chế.
- Các nhóm MLOps doanh nghiệp: Giảm đáng kể chi phí và thời gian huấn luyện các mô hình nội bộ cho các tác vụ như hỗ trợ khách hàng, phân tích tài liệu hoặc tạo mã.
- Các nhà phát triển cá nhân & người có sở thích: Thử nghiệm và tìm hiểu về tinh chỉnh LLM trên máy tính cá nhân, hạ thấp rào cản gia nhập để phát triển AI tiên tiến.
- Các nhà khoa học dữ liệu: Nhanh chóng tinh chỉnh các mô hình trên các tập dữ liệu cụ thể để trích xuất thông tin chi tiết hoặc xây dựng các công cụ dự đoán cho trí tuệ kinh doanh.
Ưu điểm của Unsloth
Ưu điểm chính của Unsloth là hiệu quả vô song của nó. Bằng cách giải quyết các nút thắt cốt lõi về tốc độ và bộ nhớ, nó dân chủ hóa quyền truy cập vào tùy chỉnh AI mạnh mẽ. Điều này dẫn đến tiết kiệm chi phí đáng kể cho phần cứng GPU và dịch vụ đám mây. Bản chất mã nguồn mở của nó thúc đẩy tính minh bạch và cải tiến do cộng đồng thúc đẩy, trong khi việc tích hợp liền mạch với hệ sinh thái Hugging Face đảm bảo rằng nó dễ dàng được áp dụng cho bất kỳ ai đã ở trong lĩnh vực này. Cuối cùng, Unsloth trao quyền cho người dùng để đạt được nhiều hơn với ít hơn, biến một quy trình từng tốn nhiều tài nguyên thành một quy trình nhanh chóng và dễ tiếp cận.
Giá cả và gói dịch vụ
Unsloth hoạt động theo mô hình freemium với ba cấp độ riêng biệt:
- Miễn phí: Đây là phiên bản phần mềm miễn phí mã nguồn mở của Unsloth. Nó cung cấp tăng tốc 2 lần, giảm 60% VRAM và hỗ trợ thiết lập một GPU. Nó hoàn hảo cho các cá nhân và các dự án quy mô nhỏ, hỗ trợ tinh chỉnh LoRA 4-bit và 16-bit cho các mô hình như Mistral, Gemma và Llama.
- Unsloth Pro: Hướng đến các chuyên gia và đội nhóm, gói này cung cấp tăng tốc 2,5 lần cho mỗi GPU, giảm 80% VRAM và hỗ trợ đa GPU nâng cao (lên đến 8 GPU). Gói này phù hợp cho mọi trường hợp sử dụng đòi hỏi nhiều sức mạnh và hiệu quả hơn. Giá cả có sẵn khi liên hệ với nhóm Unsloth.
- Unsloth Enterprise: Cấp hiệu suất cuối cùng cho các hoạt động quy mô lớn. Nó mở khóa huấn luyện nhanh hơn tới 32 lần, giảm 90% VRAM, hỗ trợ đa nút và tăng độ chính xác lên đến 30%. Nó cũng bao gồm hỗ trợ huấn luyện mô hình đầy đủ (không chỉ LoRA), suy luận nhanh hơn 5 lần và hỗ trợ khách hàng chuyên dụng. Giá cả có sẵn khi liên hệ với nhóm Unsloth.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 426.2K
- 2026-1: 574.8K
- 2026-2: 698.3K
- 2026-3: 1.3M
- 2026-4: 1.6M
- 2026-5: 1.1M
Geography
Top 5 countries / regions
- 🇨🇳Trung Quốc43.4%
- 🇺🇸Hoa Kỳ30.2%
- 🇮🇳Ấn Độ11.4%
- 🇰🇷Hàn Quốc7.9%
- 🇩🇪Đức7.1%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 64.9% |
Referral | 34.0% |
Email | 1.1% |
Top keywords
| Keyword | Cost per click |
|---|---|
| kimi k2.6 | $0.00 |
| qwen3.5 | $0.00 |
| unsloth | $2.86 |
| unsloth ai | $3.35 |
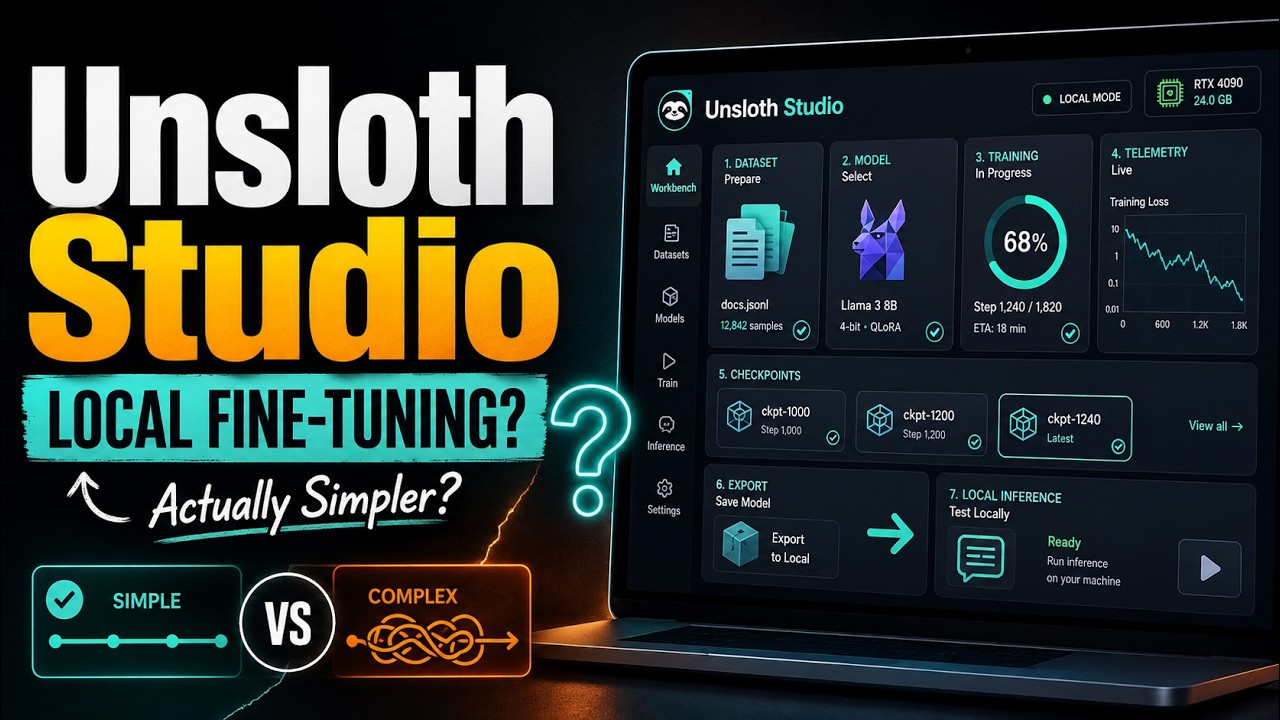
| unsloth studio | $2.57 |
Unsloth Videos on YouTube

Byte Goose AI.



Docker

Unsloth Alternatives
xTuring
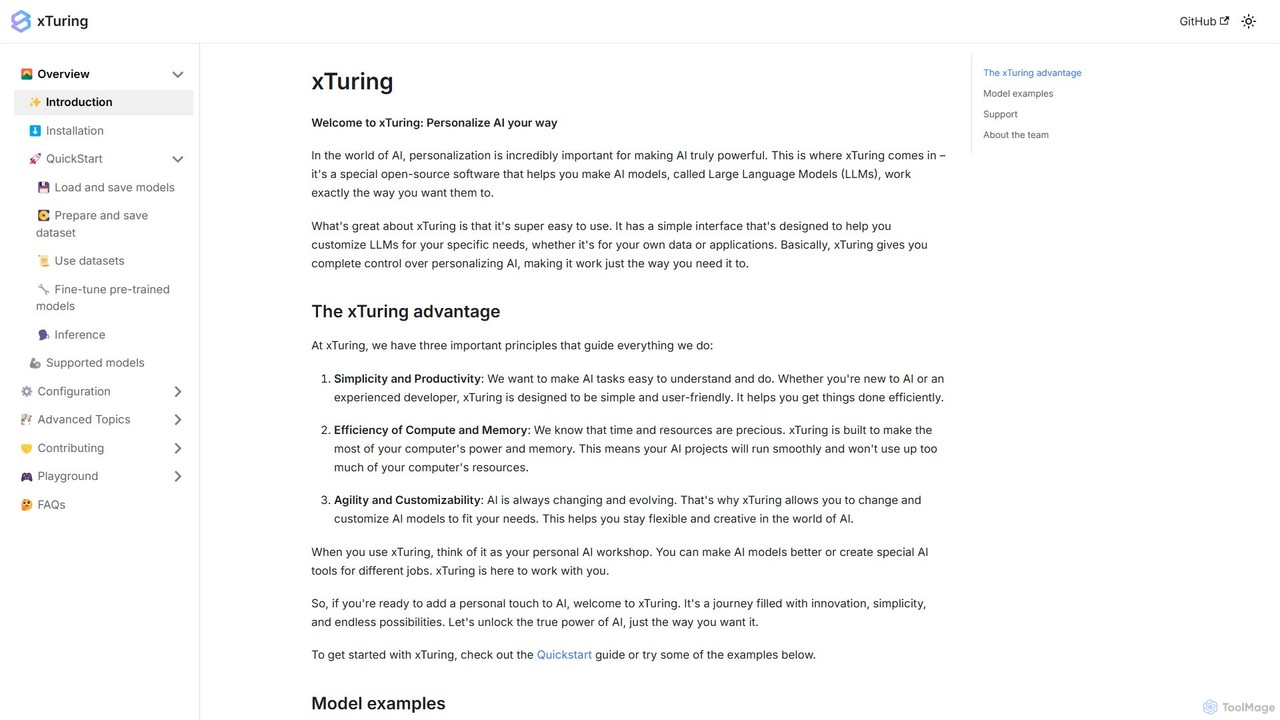
xTuring là một thư viện Python mã nguồn mở được thiết kế để đơn giản hóa quá trình xây dựng, tinh chỉnh và kiểm soát các Mô hình Ngôn ngữ Lớn (LLM). Nó cung cấp một giao diện thân thiện với người dùng cho các nhà phát triển và nhà nghiên cứu để cá nhân hóa các mô hình AI cho dữ liệu và ứng dụng cụ thể với hiệu quả và khả năng tùy chỉnh cao.
Huấn luyện mô hình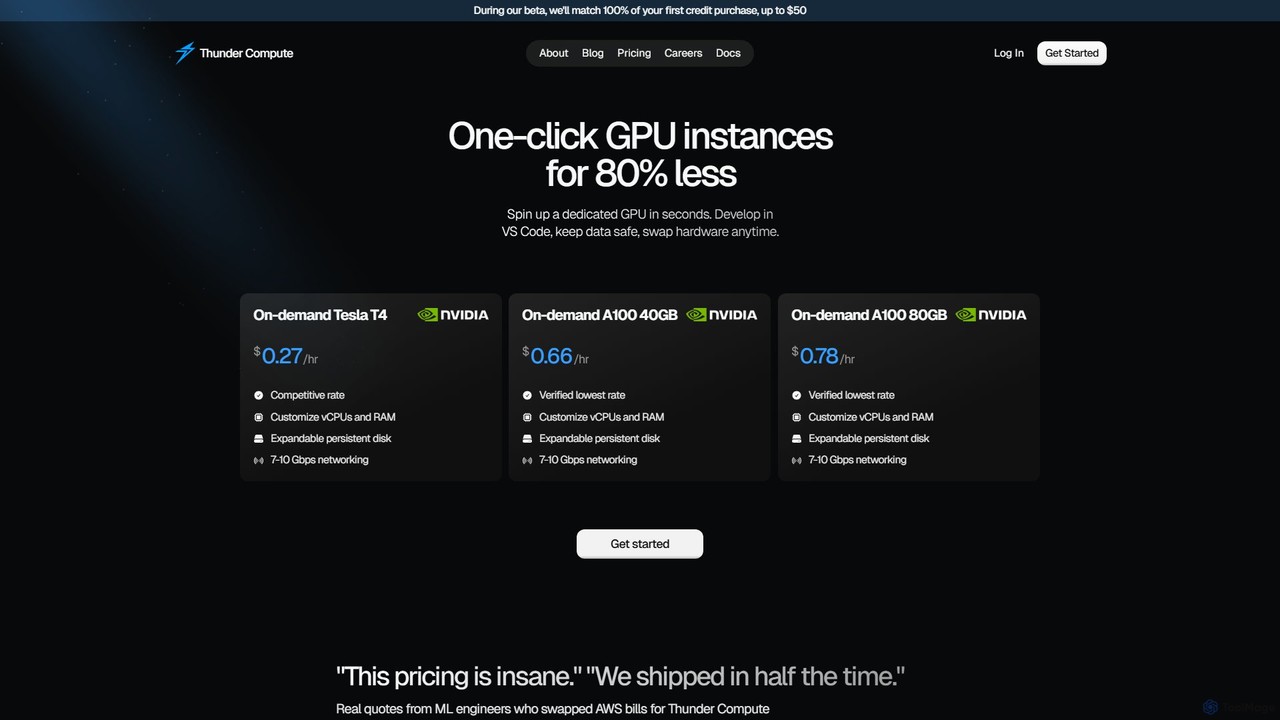
thundercompute
Thunder Compute cung cấp một nền tảng đám mây GPU chi phí cực thấp được thiết kế cho các nhà phát triển AI và học máy. Nó cung cấp các phiên bản GPU theo yêu cầu như NVIDIA A100 và T4 với giá thấp hơn tới 80% so với các nhà cung cấp đám mây lớn. Với các tính năng như thiết lập bằng một cú nhấp chuột, tích hợp VS Code và khả năng mở rộng liền mạch, nó đơn giản hóa đáng kể quy trình làm việc phát triển, từ tạo mẫu đến sản xuất, cho phép các nhà phát triển tập trung vào việc xây dựng mô hình thay vì quản lý cơ sở hạ tầng.
Học máy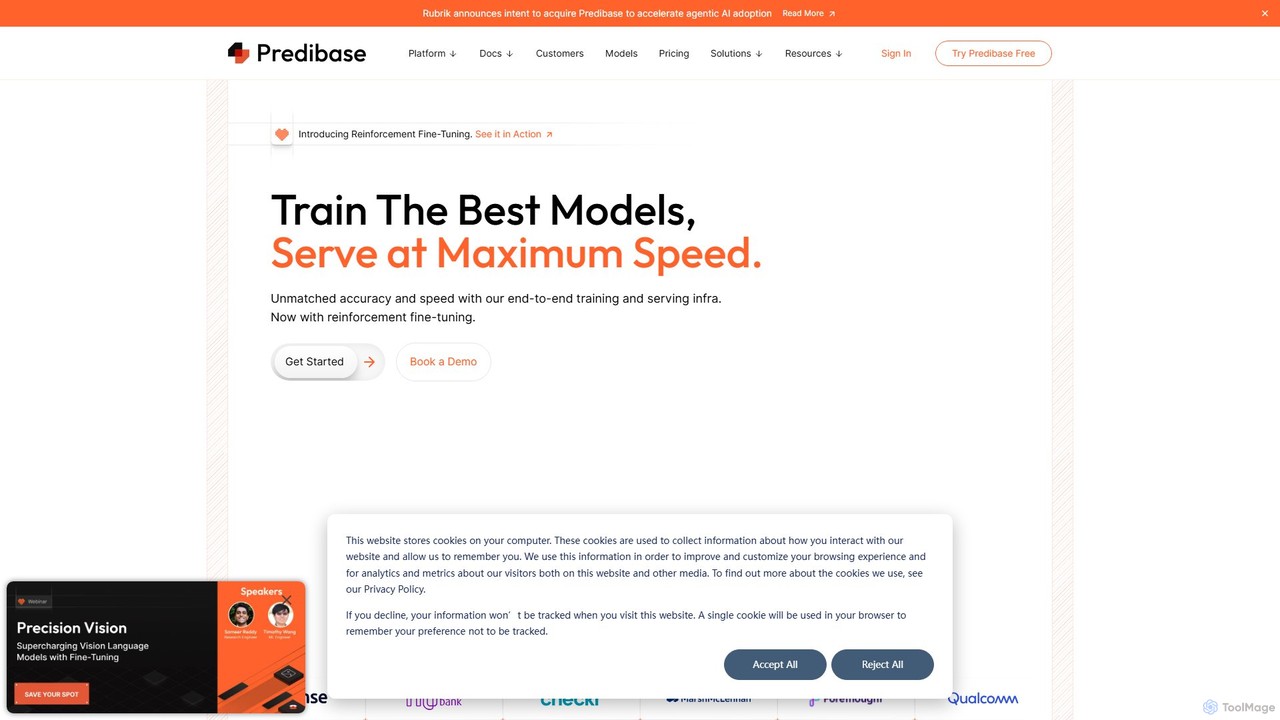
Predibase
Predibase là một nền tảng phát triển toàn diện để tinh chỉnh và phục vụ các Mô hình Ngôn ngữ Lớn (LLM) mã nguồn mở một cách hiệu quả. Nó cho phép người dùng xây dựng các mô hình AI tùy chỉnh vượt trội hơn các mô hình độc quyền lớn như GPT-4 trong các tác vụ cụ thể, đồng thời giảm đáng kể chi phí và độ trễ suy luận. Nền tảng này có các kỹ thuật tiên tiến như Tinh chỉnh bằng Học tăng cường (RFT) và LoRAX để phục vụ đa mô hình tốc độ cao.
Học máy
Fluidstack
Fluidstack là một nền tảng đám mây AI hàng đầu cung cấp các cụm GPU chuyên dụng, hiệu suất cao để huấn luyện và phục vụ các mô hình AI tiên tiến. Nền tảng này cho phép triển khai nhanh chóng hàng nghìn GPU, dịch vụ được quản lý hoàn toàn với sự hỗ trợ của chuyên gia 24/7 và giá cả minh bạch không có phí truyền dữ liệu ra ngoài, giúp các nhóm AI mở rộng quy mô mà không gặp trở ngại về cơ sở hạ tầng.
Giải pháp Doanh nghiệp
Nebius
Nebius là một nền tảng đám mây hiệu suất cao được thiết kế đặc biệt cho các khối lượng công việc AI và Học máy đòi hỏi khắt khe. Nó cung cấp quyền truy cập có thể mở rộng vào các GPU NVIDIA mới nhất, từ các phiên bản đơn lẻ đến các cụm lớn, được bổ sung bởi một bộ dịch vụ được quản lý và một AI Studio tích hợp để hợp lý hóa toàn bộ vòng đời ML từ đào tạo đến suy luận.
Điện toán đám mây GPUUnsloth Categories
Unsloth Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
xTuring
xTuring là một thư viện Python mã nguồn mở được thiết kế để đơn giản hóa quá trình xây dựng, tinh chỉnh và kiểm soát các Mô hình Ngôn ngữ Lớn (LLM). Nó cung cấp một giao diện thân thiện với người dùng cho các nhà phát triển và nhà nghiên cứu để cá nhân hóa các mô hình AI cho dữ liệu và ứng dụng cụ thể với hiệu quả và khả năng tùy chỉnh cao.
Huấn luyện mô hình
Ludwig
Ludwig là một framework học sâu mã nguồn mở, ít code, giúp đơn giản hóa việc xây dựng và huấn luyện các mô hình AI tùy chỉnh. Sử dụng cấu hình YAML khai báo, người dùng có thể dễ dàng tạo các mô hình phức tạp, bao gồm cả LLM, cho học đa phương thức và đa nhiệm vụ mà không cần nhiều mã soạn sẵn. Nó được thiết kế để có khả năng mở rộng, sẵn sàng cho sản xuất và tích hợp với các công cụ phổ biến như HuggingFace và MLFlow.
Đào tạo mô hình
FinetuneDB
FinetuneDB là một nền tảng tinh chỉnh AI tất cả trong một dành cho nhà phát triển. Nó đơn giản hóa toàn bộ quy trình tạo Mô hình Ngôn ngữ Lớn (LLM) tùy chỉnh, từ việc xây dựng bộ dữ liệu chất lượng cao và tinh chỉnh các mô hình như Llama 3 và GPT-4o mini, đến việc triển khai và đánh giá liên tục trên một nền tảng duy nhất, an toàn.
Llmopsthundercompute
Thunder Compute cung cấp một nền tảng đám mây GPU chi phí cực thấp được thiết kế cho các nhà phát triển AI và học máy. Nó cung cấp các phiên bản GPU theo yêu cầu như NVIDIA A100 và T4 với giá thấp hơn tới 80% so với các nhà cung cấp đám mây lớn. Với các tính năng như thiết lập bằng một cú nhấp chuột, tích hợp VS Code và khả năng mở rộng liền mạch, nó đơn giản hóa đáng kể quy trình làm việc phát triển, từ tạo mẫu đến sản xuất, cho phép các nhà phát triển tập trung vào việc xây dựng mô hình thay vì quản lý cơ sở hạ tầng.
Học máyPredibase
Predibase là một nền tảng phát triển toàn diện để tinh chỉnh và phục vụ các Mô hình Ngôn ngữ Lớn (LLM) mã nguồn mở một cách hiệu quả. Nó cho phép người dùng xây dựng các mô hình AI tùy chỉnh vượt trội hơn các mô hình độc quyền lớn như GPT-4 trong các tác vụ cụ thể, đồng thời giảm đáng kể chi phí và độ trễ suy luận. Nền tảng này có các kỹ thuật tiên tiến như Tinh chỉnh bằng Học tăng cường (RFT) và LoRAX để phục vụ đa mô hình tốc độ cao.
Học máy
Ollama
Ollama là một framework mã nguồn mở mạnh mẽ để chạy các mô hình ngôn ngữ lớn (LLM) như Llama 3, Mistral và Gemma cục bộ trên phần cứng của riêng bạn. Có sẵn cho macOS, Windows và Linux, nó đơn giản hóa việc thiết lập và quản lý các mô hình mã nguồn mở, cho phép phát triển và sử dụng AI một cách riêng tư, ngoại tuyến và tiết kiệm chi phí.
Học máy
GPT4All
GPT4All là một chatbot AI miễn phí, mã nguồn mở và tập trung vào quyền riêng tư, chạy các mô hình ngôn ngữ mạnh mẽ ngay trên máy tính của bạn. Nó hoạt động ngoại tuyến, đảm bảo dữ liệu của bạn không bao giờ rời khỏi thiết bị và cho phép bạn trò chuyện an toàn với tài liệu của riêng mình.
Học máy
GreenNode
GreenNode là nhà cung cấp cơ sở hạ tầng đám mây AI toàn diện, cung cấp các giải pháp GPU NVIDIA hiệu suất cao cho các công ty khởi nghiệp và doanh nghiệp. Nền tảng này cung cấp quyền truy cập tức thì vào các tài nguyên tiên tiến như GPU H100, cơ sở hạ tầng có thể mở rộng và sự hỗ trợ chuyên môn từ AI Lab. Tập trung vào hiệu quả chi phí và hiệu suất, GreenNode giúp tăng tốc quá trình huấn luyện, tinh chỉnh và suy luận mô hình, với sự hiện diện mạnh mẽ tại Đông Nam Á.
Huấn luyện mô hình
EntryPoint AI
EntryPoint AI là một nền tảng không cần mã được thiết kế để đơn giản hóa việc tinh chỉnh (fine-tuning) các mô hình ngôn ngữ lớn (LLM). Nó cho phép người dùng quản lý bộ dữ liệu, huấn luyện, đánh giá và triển khai các mô hình AI tùy chỉnh từ các nhà cung cấp như OpenAI mà không cần viết bất kỳ mã nào. Nền tảng này giúp cải thiện chất lượng, tốc độ và khả năng dự đoán của mô hình cho các tác vụ kinh doanh cụ thể, giúp các nhóm ở mọi quy mô có thể tùy chỉnh AI nâng cao.
Quản lý Dữ liệu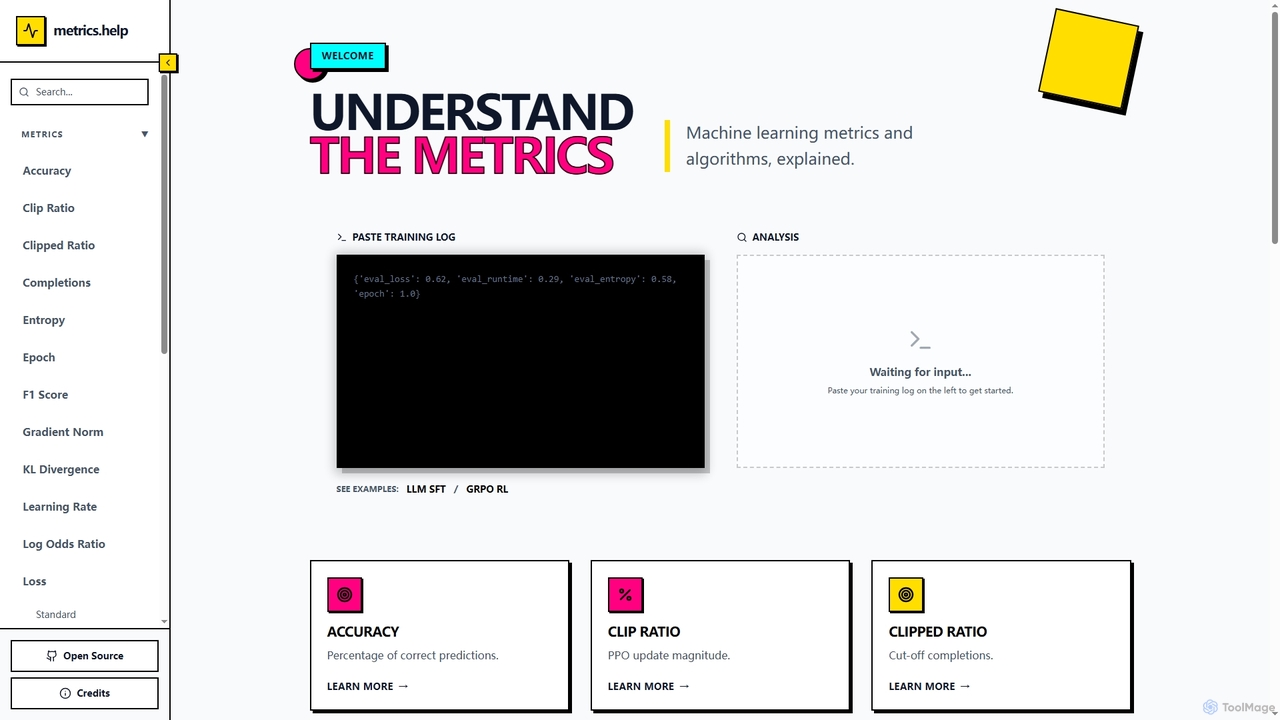
Metrics Help
Metrics Help là một công cụ web mã nguồn mở dành cho các chuyên gia học máy. Nó hoạt động như một hướng dẫn toàn diện và một trình phân tích tương tác cho các chỉ số huấn luyện ML. Người dùng có thể dán nhật ký huấn luyện để nhận giải thích tức thì về các chỉ số chính như độ chính xác, mất mát và độ phức tạp, hỗ trợ phân tích hiệu suất và gỡ lỗi mô hình.
Đào tạo mô hình
hyperficient
hyperficient là một công cụ AI mã nguồn mở dành cho các nhà phát triển và kỹ sư ML, giúp tự động hóa việc tìm kiếm các chiến lược tinh chỉnh (fine-tuning) hiệu quả nhất cho các mạng nơ-ron. Nó giảm đáng kể chi phí tính toán, thời gian GPU và công sức thủ công, cho phép đạt hiệu suất mô hình tối ưu với nguồn lực hạn chế.
Thư viện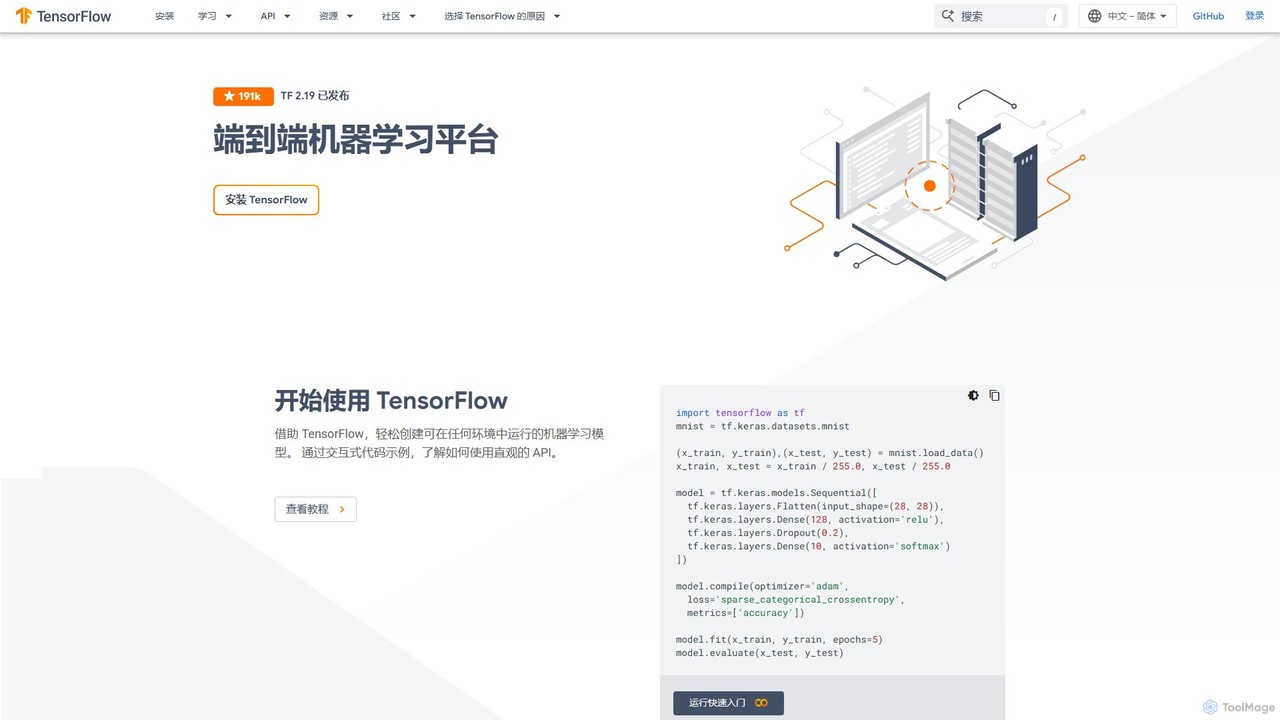
TensorFlow
TensorFlow là một nền tảng mã nguồn mở toàn diện cho học máy được phát triển bởi Google. Nó cung cấp một hệ sinh thái toàn diện, linh hoạt gồm các công cụ, thư viện và tài nguyên cộng đồng cho phép các nhà nghiên cứu và nhà phát triển xây dựng và triển khai các ứng dụng dựa trên ML. Từ người mới bắt đầu đến chuyên gia, TensorFlow cung cấp các API cấp cao trực quan để xây dựng mô hình dễ dàng và các API cấp thấp mạnh mẽ cho nghiên cứu nâng cao, cho phép triển khai trên các máy chủ, thiết bị biên và trình duyệt.
Framework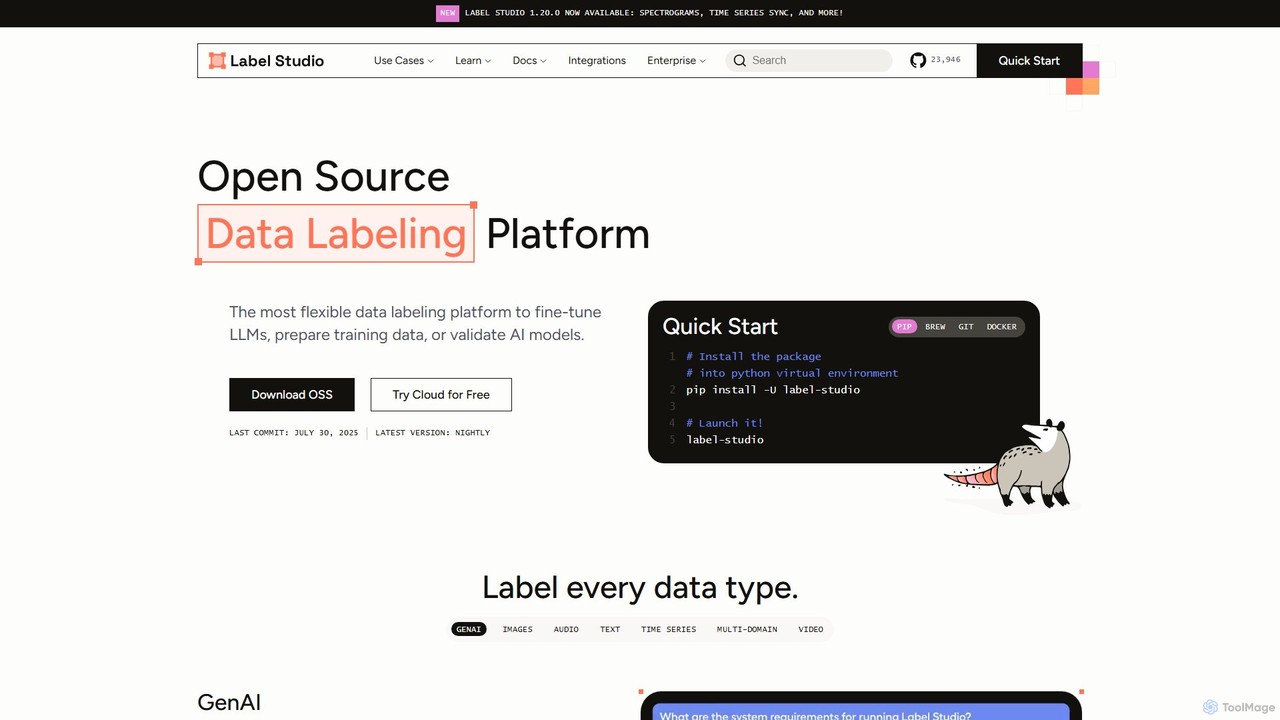
Label Studio
Label Studio là một nền tảng gán nhãn dữ liệu mã nguồn mở đa năng, được thiết kế cho nhiều loại dữ liệu khác nhau. Nó cho phép người dùng chú thích hình ảnh, văn bản, âm thanh, video và dữ liệu chuỗi thời gian để tinh chỉnh các mô hình LLM, chuẩn bị dữ liệu huấn luyện cho học máy và xác thực các mô hình AI với phản hồi từ con người trong vòng lặp.
Dữ liệu huấn luyện
Forefront
Forefront là một nền tảng dành cho nhà phát triển để xây dựng với AI mã nguồn mở. Nó đơn giản hóa việc chạy, tinh chỉnh và triển khai các mô hình ngôn ngữ lớn (LLM) trên dữ liệu riêng tư của bạn, cung cấp một giải pháp thay thế có thể mở rộng, an toàn và hiệu quả về chi phí cho các nền tảng mã nguồn đóng. Sở hữu dữ liệu, mô hình và AI của riêng bạn.
Mô hình ngôn ngữ lớn
Jyek
Jyek là một nền tảng AI agent hiểu mục tiêu, tạo kế hoạch thực thi, sử dụng công cụ và cung cấp kết quả có thể xác minh cho các tác vụ phức tạp nhiều bước.
Tự động hóa
Unsloth Comments (0)
Sign in to comment.
Đăng nhậpNo comments yet.