付费
data.world
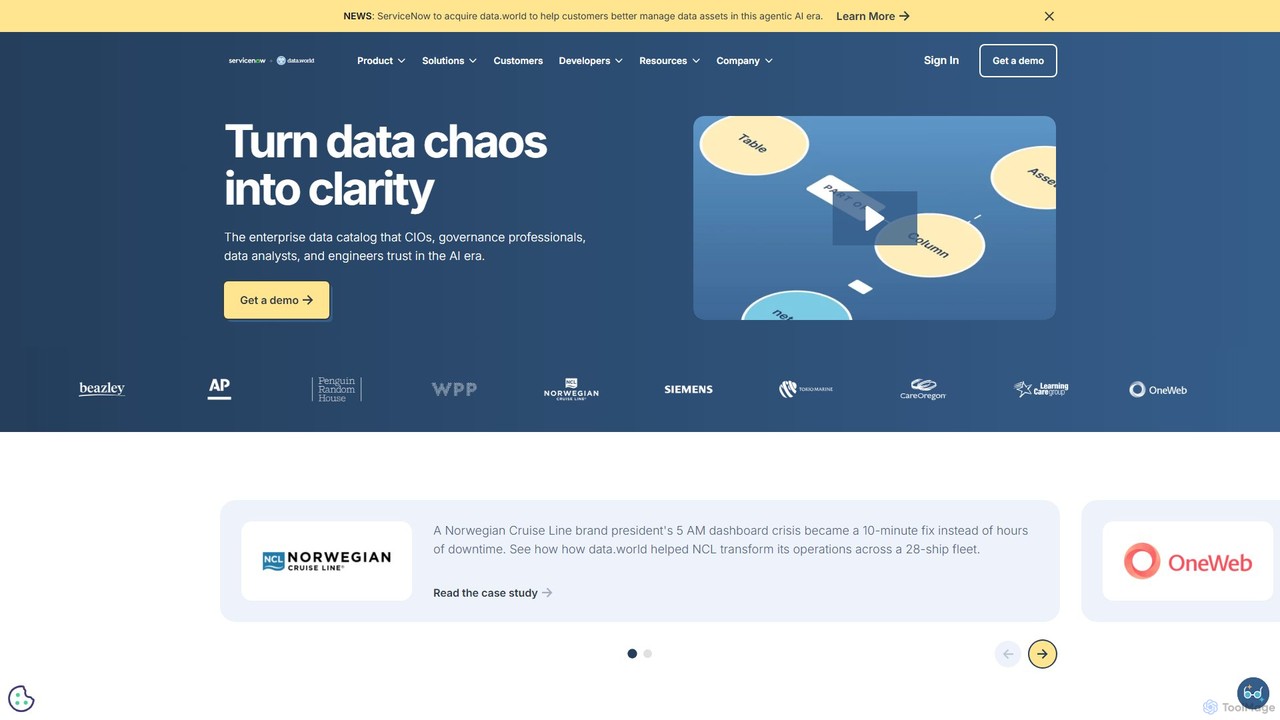
data.world 是一个企业级、由人工智能驱动的数据目录平台。它通过知识图谱基础和名为 Archie 的自然语言 AI 助手,帮助组织发现、治理和协作处理数据。它能集中管理元数据,提供清晰的数据血缘,并赋能技术和非技术用户做出数据驱动的决策。
商业智能Visits 144.6KFavorites 177Likes 158
数据领域的数据目录热门 AI 工具包括 data.world 等,帮助您快速提升效率。
data.world 是一个企业级、由人工智能驱动的数据目录平台。它通过知识图谱基础和名为 Archie 的自然语言 AI 助手,帮助组织发现、治理和协作处理数据。它能集中管理元数据,提供清晰的数据血缘,并赋能技术和非技术用户做出数据驱动的决策。
商业智能数据目录是一种创建企业内部所有数据资产的有序清单的工具,使用户可以轻松发现、理解和信任数据。它通过自动扫描各种数据源来收集元数据(关于数据的数据),并将其呈现在一个可搜索的用户友好界面中。这个集中式系统通过为数据提供单一事实来源,赋能数据专业人员和业务用户进行自助式分析,加强数据治理,并加速人工智能开发。它弥合了技术性数据存储与业务用户需求之间的鸿沟。
数据目录对于旨在成为数据驱动型组织的企业至关重要。数据治理团队广泛使用它来执行政策和跟踪合规性(例如GDPR、CCPA)。数据分析师和科学家依靠它来大幅减少搜索和审查数据的时间。在大型企业中,它通过赋能业务用户在无需IT干预的情况下找到经认证的数据,来支持自助式商业智能计划。
选择数据目录时,首先评估其连接器生态系统,确保它支持您的数据源(如Snowflake、BigQuery、Tableau)。评估其在元数据发现和血缘生成方面的自动化水平,因为这能减少手动工作。考量其协作和治理功能的强度,例如数据管理员的工作流和基于角色的访问控制。最后,检查其与数据技术栈中其他工具的集成能力。
一位业务分析师需要创建一份季度销售业绩报告。他们不再需要给IT部门发邮件并等待数天,而是使用数据目录的搜索栏查找“经认证的客户销售数据”。目录提供了该数据集的详细信息,包括列描述、数据质量得分及其刷新频率。通过查看数据血缘,分析师确认数据源自官方CRM系统,从而确保其可信度。然后,他们可以直接将这个经过验证的数据集连接到他们的商业智能工具(如Tableau),在几小时内而不是几天内完成报告,极大地提高了他们的生产力和自主性。
一位数据治理官负责确保整个组织遵守GDPR。他们使用数据目录自动扫描所有数据源,并通过自动标记功能识别包含个人可识别信息(PII)的数据集。目录的血缘视图使他们能够精确跟踪PII在不同系统中的流向以及谁有权访问它。然后,他们可以直接通过目录的界面应用数据脱敏或访问限制等治理策略。这为合规工作提供了一个集中的、可审计的记录,简化了向监管机构的报告流程,并降低了数据泄露的风险。
一位数据科学家正在启动一个新项目,以构建客户流失预测模型。他们不再需要花费数周时间来了解数据环境,而是使用数据目录。他们搜索“客户活动”和“订阅数据”,目录会返回几个相关的、经过整理的数据集。他们可以查看用户提供的评级和评论,以选择最可靠的数据集。业务术语表功能帮助他们理解“活跃用户定义”等复杂的业务术语。这个过程将数据发现和准备阶段从数周缩短到数天,使他们能够将更多时间专注于模型开发和实验,最终加速人工智能项目的交付。
一个数据工程团队计划在一个关键数据库表中弃用一个列。在进行更改之前,他们使用数据目录的端到端血缘功能进行影响分析。血缘图直观地显示了所有依赖此列的下游资产,包括数据管道、商业智能仪表板和机器学习模型。这使团队能够主动识别并通知所有受影响的利益相关者。如果没有目录,这个过程将是手动的、容易出错的,需要检查代码和查询日志。有了它,他们可以自信地管理数据基础设施的变更,防止意外中断并维护数据完整性。
一位新数据分析师加入公司,需要快速了解复杂的数据环境。他们不再依赖过时的文档或占用资深成员的时间,而是被引导至数据目录。他们可以探索最常用和经认证的数据集,通过血缘视图了解不同数据资产之间的关系,并从业务术语表中学习公司特定的术语。这种自助服务的方式使新员工在第一周内就能变得富有成效,缩短了入职时间,并从第一天起就培养了数据素养文化。
一个组织希望打破数据孤岛并鼓励知识共享。他们利用其数据目录的社交功能。当一位营销分析师发现一个对广告活动分析特别有用的数据集时,他们会对其进行认证,并添加评论,提供如何有效使用它的技巧。一位数据工程师看到评论后,补充了有关数据来源的更多背景信息。这创造了一个良性循环,用户用他们的集体知识丰富了目录。目录不仅仅是一个清单;它转变为一个活跃的、协作的数据中心,围绕组织最宝贵的资产建立信任并培养实践社区。
AI驱动的数据目录是组织数据资产的智能清单。与传统目录不同,它利用人工智能和机器学习来自动化关键任务,例如发现数据源、分类敏感数据(如个人可识别信息)、分析数据质量以及绘制数据血缘。它充当一个集中的、可搜索的平台,技术和业务用户都可以在此找到、理解和信任他们所需的数据。其主要目标是通过使数据发现像网络搜索一样简单,来加速数据分析和治理。
选择合适的数据目录需要评估几个关键因素。首先,评估其连接性:确保它为您所有关键数据源(数据库、数据湖、商业智能工具)提供预构建的连接器。其次,评估元数据采集和血缘映射的自动化水平,以最大限度地减少手动工作。第三,考虑其协作和治理功能,例如业务术语表、数据管理工作流和策略执行。最后,检查其与您现有数据技术栈的集成能力以及它为技术和非技术用户提供的整体用户体验。
数据目录和数据字典的用途不同。数据字典是一种技术性的、被动的资源,通常专注于单个数据库。它定义了结构:表、列、数据类型和约束。相比之下,数据目录是一个动态的、主动的平台,涵盖整个组织的所有数据资产。它超越了技术定义,包含了业务背景、数据血缘、使用统计、质量得分和协作注释。本质上,数据字典告诉你数据结构*是什么*,而数据目录帮助你*发现、理解和信任*数据本身。
实施数据目录的主要好处集中在效率、信任和治理上。主要好处包括:
数据目录服务于组织内的多种角色。主要用户包括: