
免费增值
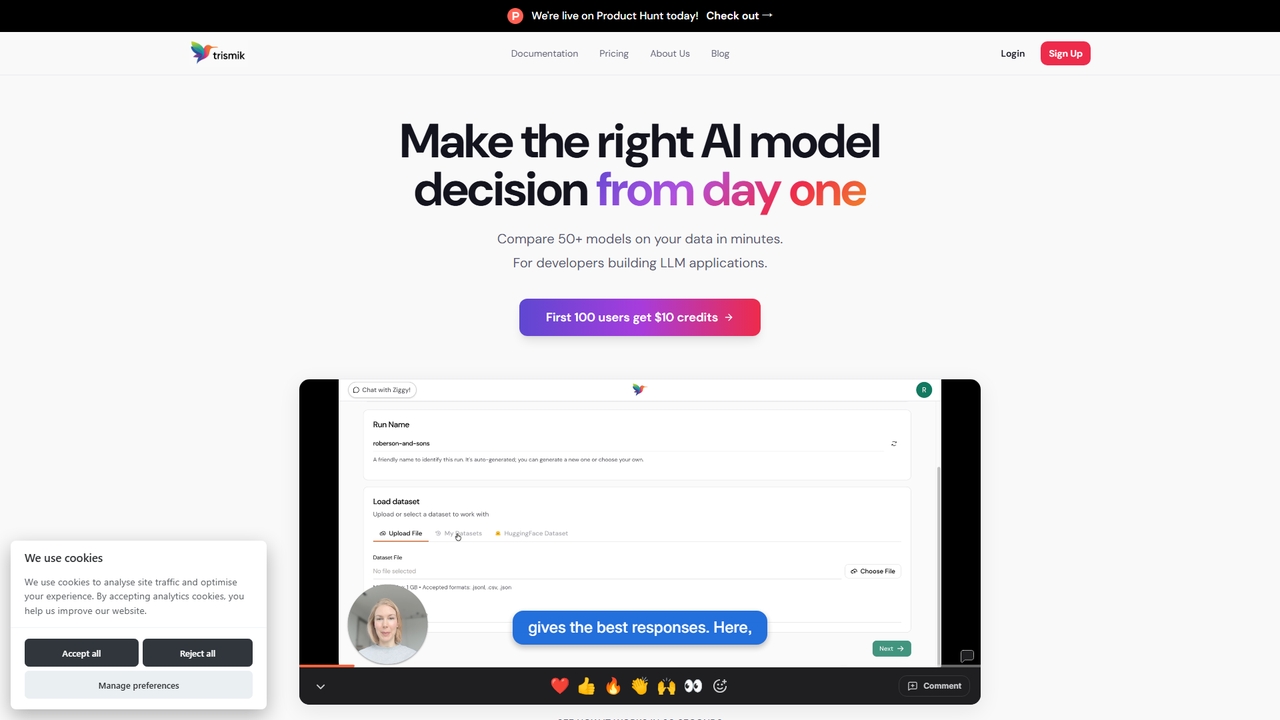
Trismik
几分钟内在您自己的数据上比较50多个LLM模型。基于证据做出关于质量、成本和速度的模型决策,无需猜测。
Ai Model SelectionVisits 10.5KFavorites 55Likes 55
开发者工具领域的模型比较热门 AI 工具包括 Trismik、Compare AI Models、Joythee AI 等,帮助您快速提升效率。
几分钟内在您自己的数据上比较50多个LLM模型。基于证据做出关于质量、成本和速度的模型决策,无需猜测。
Ai Model Selection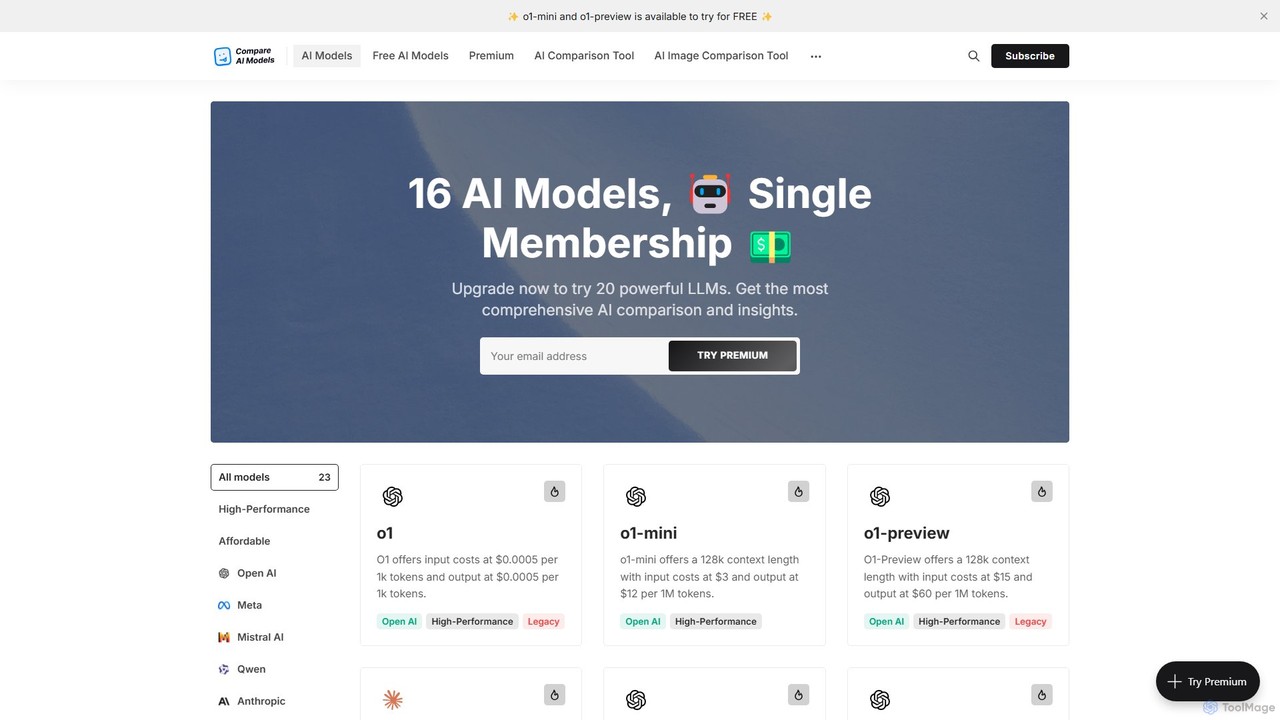
一个全面的平台,用于比较超过20种领先的大型语言模型(LLM)。它提供关于性能、API定价、上下文窗口和功能的详细指标,并附带免费聊天功能以直接测试模型。是开发人员、研究人员和企业寻找完美AI的必备工具。
LLM 目录
Joythee AI 是一个先进的对话式AI平台,允许您同时与多个AI代理聊天。在单一界面中比较来自各种大语言模型(LLM)的回复,享受个性化对话,并通过无痕模式保护您的隐私。是个人、团队和企业寻求提高生产力和创造力的理想选择。
模型比较模型比较工具是开发者工具包中的一类专业平台,旨在系统性地评估、基准测试和比较不同AI模型的性能。这些工具提供一个结构化环境,用于针对相同的输入和数据集运行语言模型或图像生成器等模型,从而客观地衡量其输出。它们对于制定数据驱动的决策至关重要,帮助开发者和研究人员为其特定应用选择最准确、最具成本效益和最高效的模型。通过提供并排分析和量化指标,这些工具简化了原本复杂耗时的模型选择过程。
这些工具对AI开发者、MLOps工程师和产品经理在开发和维护生命周期中至关重要。它们可用于为新功能选择基础模型、评估微调效果,或在模型更新后进行回归测试。例如,一个构建客服聊天机器人的团队会使用这些工具来比较来自OpenAI、Anthropic和Google的模型的对话能力和成本,然后再决定使用哪一个。
选择模型比较工具时,应考虑其支持模型的广度,包括商业API和开源选项。评估其提供的基准测试套件以及创建自定义评估数据集的灵活性。考察其与现有MLOps工作流和CI/CD管道的集成能力。最后,还需考虑支持团队成员审查结果的协作功能,以及能随评估需求扩展的定价模式。
一个产品团队正在开发一款新的人工智能客服聊天机器人。他们使用模型比较工具来评估GPT-4、Claude 3 Sonnet和Llama 3 70B。团队创建了一个包含100个常见客户查询的“黄金数据集”,并用它来测试这三个模型。该平台提供了并排的响应视图,以及关于实用性和语气的自动化指标。它还计算了每个模型每1000次对话的平均成本。根据结果,他们选择了Claude 3 Sonnet,因为它在对话质量和运营成本之间为他们的特定用例提供了最佳平衡。
一位机器学习工程师在公司内部文档上微调了一个开源的Mistral 7B模型,用于问答任务。为了证明部署的合理性,他们使用比较工具将微调后的模型与基础Mistral 7B模型以及像GPT-4这样的专有模型进行基准测试。他们上传了一个包含50个技术问题的测试集。该工具衡量了事实准确性和相关性。结果显示,他们微调后的模型在准确性上比基础模型高出30%,并且成本比GPT-4便宜10倍,为继续部署提供了明确的证据。
一个MLOps团队管理着一个依赖外部模型API的摘要功能。API提供商宣布了一个新版本。在切换之前,该团队使用一个模型比较平台,将他们的500个测试文档套件分别通过新旧API版本运行。该平台会自动标记出新版本生成的任何与旧版本输出相比明显更短、连贯性更差或事实不正确的摘要。这种自动化的回归测试可以防止服务质量下降,并确保平稳过渡到更新后的模型。
一家营销机构需要选择一个图像生成模型来创作广告素材。他们使用比较工具,用20个与客户产品相关的不同提示词来测试DALL-E 3、Midjourney和Stable Diffusion。该工具允许他们的创意团队对每个生成的图像在提示词遵循度、美学质量和品牌契合度方面进行1-5分的评分。汇总的分数显示,虽然Midjourney生成的图像在美学上最令人愉悦,但DALL-E 3在准确地融入提示词中提到的特定产品细节方面更胜一筹,因此成为满足他们需求的更好选择。
一家新闻聚合服务使用大语言模型来摘要文章。为了降低成本,他们希望找到在保持质量的同时最便宜的模型。通过使用比较工具,他们测试了五种不同的模型,从高端的GPT-4到更小的开源替代品。他们让每个模型处理1000篇文章,并使用自动化的ROUGE分数来衡量摘要质量,同时该工具跟踪每个模型的成本。他们发现,一个量化版的Llama 3 8B模型能提供GPT-4 95%的质量,而成本仅为其10%,从而实现了可观的月度节省。
一位提示词工程师的任务是为代码生成功能创建最有效的提示词。他们没有逐一测试提示词,而是使用模型比较工具来设置一个矩阵实验。他们输入三种不同的提示词变体,并在四种模型(例如GPT-4、Claude 3 Opus、Gemini Pro和一个专门的代码模型)上进行测试。该平台运行所有12种组合,并以热图形式呈现结果,显示哪个提示词-模型对能生成最准确、最高效的代码。这将提示词优化过程的速度提高了十倍。
AI模型比较工具是专门的软件平台,使开发者和研究人员能够系统地评估和基准测试多个AI模型。用户无需手动测试每个模型,这些工具提供统一的界面,可以同时在不同模型(如GPT-4、Claude 3和Llama 3)上运行相同的提示或数据集。它们会测量并显示关键指标,如输出质量、成本、延迟以及在标准化测试中的表现,从而在为特定任务选择最佳模型时,能够做出客观、数据驱动的决策。
选择合适的工具取决于您的具体需求。请考虑以下因素:
模型比较和模型监控是MLOps生命周期中两个不同的阶段。模型比较是部署前的活动。它是在模型投入生产之前,从一组候选模型中选择最佳模型。您在一个静态测试数据集上比较模型,以评估其核心能力。模型监控是部署后的活动。它涉及跟踪生产中实时模型的性能,观察诸如数据漂移、性能下降或在真实世界用户数据下的意外行为等问题。简而言之,比较帮助您选择正确的模型,而监控确保所选模型保持正确。
比较AI模型的指标可分为两大类:
一次全面的评估会结合使用这两种指标,以全面了解模型的性能。
模型比较工具对于参与构建AI产品的各类专业人士都很有价值。主要用户包括: