免费增值
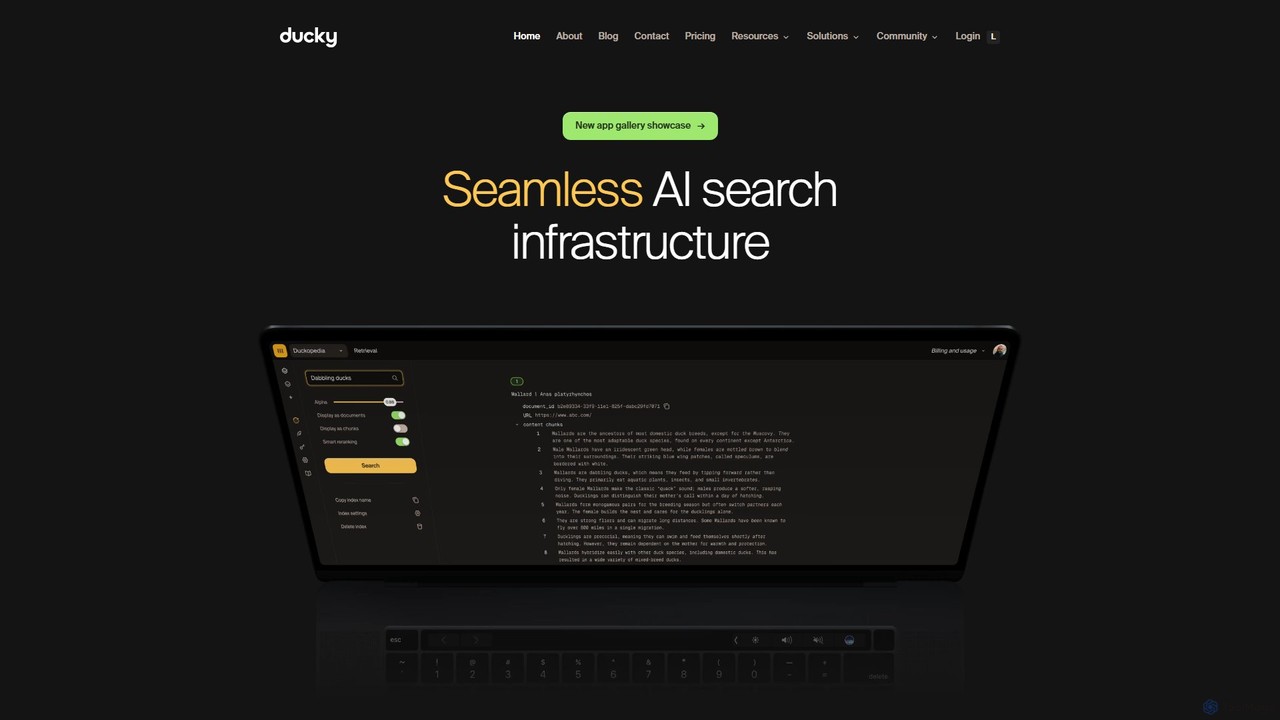
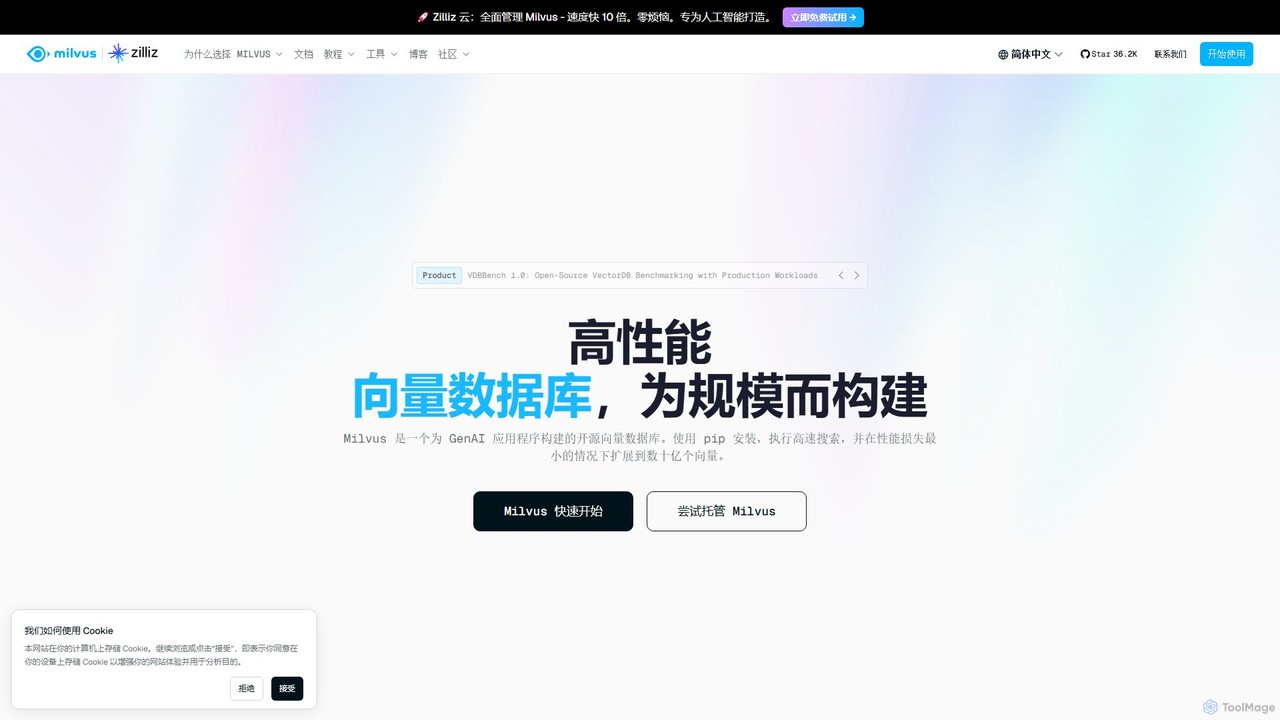
數據領域的向量搜尋熱門 AI 工具包括 Milvus、Ducky 等,幫助您快速提升效率。
向量搜尋工具是一類專業的資料檢索系統,它基於語義相似性而非精確關鍵詞匹配來尋找資訊。其工作原理是將文字、圖像或音訊等資料轉換為稱為「向量」的數值表示,然後在高維空間中搜尋最接近的向量。這使得應用程式能夠理解上下文和含義,從而驅動更直觀、更準確的搜尋體驗、推薦引擎和AI知識庫。與傳統搜尋不同,向量搜尋在處理複雜查詢和非結構化資料方面表現出色。
向量搜尋對於建構現代AI應用的開發者和資料科學家至關重要。它是AI聊天機器人檢索增強生成(RAG)系統、電商視覺推薦引擎以及內容去重平台的支柱技術。此外,它還應用於安全領域的異常偵測和科學研究中複雜資料集的模式匹配。
選擇向量搜尋工具時,需考慮其在預期負載下的可擴展性和效能。評估其支援的索引演算法以及在速度和準確性之間的權衡。考察其與嵌入模型和現有資料基礎設施的整合能力。此外,還應比較部署選項(雲端託管、自行託管)以及相關的定價模式和技術開銷。
一位AI開發者負責建構一個客戶支援聊天機器人,該機器人需要能根據龐大的技術文件庫回答複雜問題。他們沒有選擇微調大型語言模型,而是使用了向量搜尋系統。首先,所有文件被分塊並轉換為向量嵌入。當使用者提問時,問題也被轉換為向量。然後,系統執行向量搜尋,找到語義上最相似的文件塊。這些相關的文件塊作為上下文提供給一個語言模型,由該模型生成一個準確且有來源依據的回答。這種被稱為「檢索增強生成」(RAG)的方法,顯著提高了回答的準確性並減少了「幻覺」現象的發生。
一個電商平台希望改進其「相似產品」功能。基於標籤和分類的傳統方法常常無法捕捉視覺上的細微差別。透過實施向量搜尋引擎,他們將每個產品圖片轉換為向量嵌入。當顧客查看某個產品時,該產品的圖片向量被用來查詢資料庫中最近鄰的向量。結果是一個在風格、顏色和圖案上視覺相似的產品列表,即使它們的元資料描述完全不同。這帶來了更具吸引力的使用者體驗,增加了產品發現率,並提高了轉化率,因為顧客可以輕鬆找到符合其審美偏好的替代品。
一家大型媒體公司管理著數百萬篇文章和圖片。他們面臨兩個挑戰:防止重複內容上傳和幫助使用者發現相關文章。他們使用向量搜尋資料庫來儲存其所有內容的嵌入。當一篇新文章提交時,其內容被轉換為向量並與資料庫進行比對。如果一個非常接近的向量已經存在,該文章就會被標記為潛在的重複內容,從而節省了編輯時間。對於讀者,當他們讀完一篇文章時,該文章的向量被用來尋找其他具有相似語義內容的文章,從而提供比簡單的基於分類的連結更相關的「下一篇閱讀」建議。
一位網路安全分析師需要監控網路流量,以發現可能預示威脅的異常活動。他們使用向量搜尋系統來為正常的網路行為建模。每個網路事件(如登入嘗試或資料傳輸)都根據其屬性被轉換為一個向量。隨著時間的推移,這些向量形成了代表正常操作的叢集。系統持續將新事件轉換為向量,並搜尋其最近鄰。如果一個新事件的向量遠離任何現有叢集(即它沒有近鄰),它就會被標記為異常,需要立即進行調查。這使得能夠偵測到基於簽章的系統會錯過的、新穎的零日威脅。
一位記者需要核實一張在社交媒體上流傳的照片的真實性。他們使用一個由向量搜尋驅動的反向圖片搜尋工具。記者上傳圖片,該工具立即將其轉換為向量嵌入。然後,這個向量被用來在一個預先索引好的、包含全網海量圖片的資料庫中進行搜尋。搜尋在幾毫秒內返回視覺上相似的圖片,使記者能夠識別照片的原始來源、上下文和日期。這個過程透過快速揭穿虛假或斷章取義的圖片來幫助打擊虛假資訊,而這是基於關鍵詞的搜尋無法完成的任務。
一位生物資訊學家正在尋找與一種新發現的分子具有相似特性的化合物。將分子基於其結構和化學特性表示為向量嵌入,可以在海量規模上進行相似性搜尋。研究人員將新分子的向量輸入到一個包含數百萬已知化合物的向量搜尋資料庫中。系統返回一個按相似度排序的分子列表,極大地縮小了實驗室測試的候選範圍。同樣的原理也適用於基因組學,向量搜尋可以識別具有相似功能模式的基因序列,從而加速對疾病和治療方法的研究。
向量搜尋是一種基於語義和上下文來檢索資訊的方法,而非依賴精確的關鍵詞匹配。它的工作原理是將非結構化資料(如文字、圖片或音訊)轉換為稱為「向量嵌入」的數值表示。然後,這些向量被儲存在一個專門的資料庫中。當使用者發起查詢時,查詢內容同樣被轉換為一個向量,系統會在資料庫中尋找在高維空間裡與查詢向量最接近的向量。這使得系統能夠找到概念上相似的項目,即使它們使用了不同的詞語或視覺元素。
主要區別在於它們如何解讀查詢和資料。傳統關鍵詞搜尋依賴於文本字串的精確或部分匹配,它會尋找包含您輸入的特定詞語的文件。而向量搜尋則能理解查詢背後的語義或概念。它會尋找在上下文和概念上相似的資料,即使這些資料不包含完全相同的關鍵詞。例如,用關鍵詞搜尋「car」不會找到關於「automobile」的文件,但向量搜尋可以,因為它理解它們是語義相關的概念。
選擇合適的向量搜尋工具取決於您的具體需求。請考慮以下因素:
「嵌入」(embedding)是在向量搜尋中代表一段資料的數值向量。它是一個數字列表(通常有數百或數千個),捕捉了原始資料(如一個詞、一個句子、一張圖片或一段音訊)的語義精髓。這些嵌入是由深度學習模型(如用於文字的BERT或用於圖像的CLIP)創建的,這些模型都在海量資料上進行過訓練。嵌入的關鍵特性是,語義上相似的項目其向量在高維向量空間中會彼此靠近,這正是使向量搜尋成為可能的原因。
向量搜尋工具主要面向需要建構理解非結構化資料的應用程式的開發者、資料科學家和機器學習工程師。主要使用者包括: