
免费
JSON Formatter
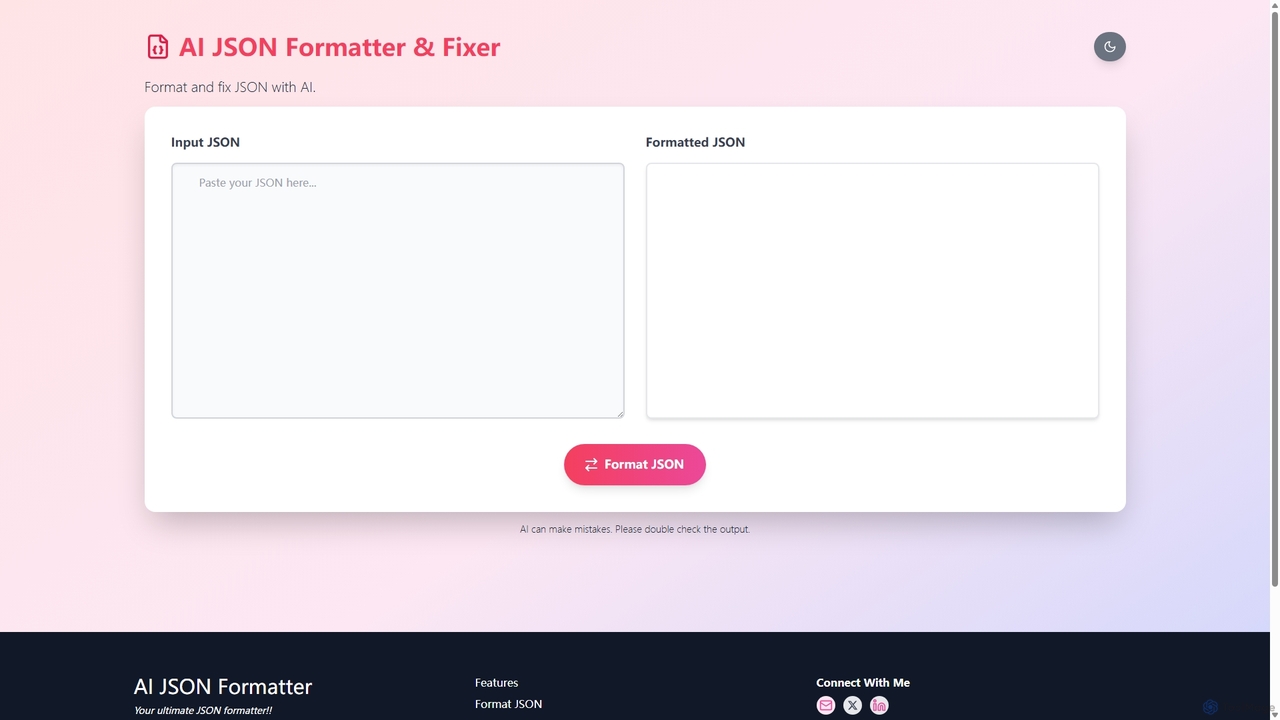
一款由AI驅動的線上工具,用於格式化、驗證和修復JSON資料。它提供即時格式化、智慧錯誤糾正和檔案上傳功能,是開發人員高效偵錯和管理JSON的必備工具。
程式助理Visits 7.5KFavorites 134Likes 136
開發者工具領域的數據處理熱門 AI 工具包括 JSON Formatter 等,幫助您快速提升效率。
一款由AI驅動的線上工具,用於格式化、驗證和修復JSON資料。它提供即時格式化、智慧錯誤糾正和檔案上傳功能,是開發人員高效偵錯和管理JSON的必備工具。
程式助理AI數據處理工具是一類專門的開發者工具,旨在自動化和簡化複雜資料集的處理流程。它們利用機器學習演算法執行資料清理、轉換、特徵工程和驗證等任務,是MLOps生命週期中的關鍵部分。這些工具對於為機器學習模型準備高品質資料、加速開發週期以及確保AI驅動應用程式中的資料完整性至關重要。透過智慧識別模式和異常,它們能顯著減少資料準備中所需的人工投入。
這些工具主要由資料科學家、機器學習工程師和資料工程師使用。常見場景包括為新的預測模型準備訓練資料、為即時應用程式建構穩健且自適應的資料管道,或為自然語言處理(NLP)任務清理大規模非結構化文字資料。
選擇AI數據處理工具時,應考慮其資料來源相容性(資料庫、API、檔案格式)、處理資料量的可擴展性,以及與現有MLOps技術棧(如TensorFlow、PyTorch、雲端平台)的整合能力。此外,還需評估其自動化水平與自訂規則需求的平衡,確保工具符合團隊的工作流程和技術能力。
一位機器學習工程師負責建立一個詐欺偵測模型。原始交易資料不一致,存在缺失值、多樣的貨幣格式和雜亂的文字欄位。透過使用AI資料處理工具,工程師自動化了整個流程:基於統計模式填補缺失值、將所有貨幣金額標準化為單一貨幣,並清理文字描述。該工具還建議並生成了新特徵,如「每小時交易頻率」。這使得一個乾淨、高品質的資料集在幾小時內便創建完成,而非數天,從而顯著提高了最終模型的準確性,並將手動預處理工作量減少了80%以上。
一位資料工程師負責維護一個ETL/ELT管道,該管道從多個第三方API擷取資料並載入到資料倉儲。這些API經常發生結構變動或提供格式異常的資料。工程師沒有編寫脆弱的、基於規則的腳本,而是部署了一個AI資料處理工具。該工具能自動偵測結構變化,動態調整轉換邏輯,並使用異常偵測在壞資料污染資料倉儲前將其隔離。這創建了一個更穩健、能自我修復的管道,大大減少了人工干預,並確保了下游分析所用資料的高可靠性。
一位資料科學家需要分析數千條客戶評論以提取情感和關鍵主題。原始文字充滿了拼寫錯誤、俚語和不相關的HTML標籤。手動清理這些資料將非常耗時。透過使用AI資料處理工具,他們應用預先建置的模型來執行拼寫校正、停用詞移除和命名實體識別等任務。該工具處理了整個評論語料庫,輸出結構化的、乾淨的文字,可直接輸入情感分析模型。這將專案時間從幾週縮短到幾天,並提高了NLP洞察的準確性。
一家醫療科技公司的開發團隊需要測試他們新的病患管理軟體。由於HIPAA等嚴格的隱私法規,使用真實的病患資料是不可行的。該團隊使用了一款具備合成資料生成功能的AI資料處理工具。他們向該工具提供了真實資料的結構和統計屬性。然後,該工具生成了一個大型的人工病患記錄資料集,該資料集模仿了真實世界的分布和關係,但完全不包含任何真實的個人資訊。這使得品保團隊能夠進行穩健的大規模測試,同時完全遵守隱私法規。
一位電商資料分析師需要合併來自多個供應商的產品目錄。每個供應商提供的資料格式各不相同,命名慣例不一致(例如 'Color' vs 'Colour'),屬性結構也多種多樣。透過使用AI資料處理工具,分析師可以智慧地對應和標準化這些不同的欄位。該工具的AI能夠識別語義相似性以正確合併屬性,並使用分群演算法對相似產品進行分組,識別潛在的重複項。這個過程創建了一個統一、乾淨的主產品目錄,直接提高了站內搜尋的準確性,並增強了客戶的瀏覽體驗。
一位物聯網開發者正在為工業機械建立一個預測性維護系統,該系統依賴於持續的感測器資料流(溫度、振動、壓力)。由於感測器故障,這些資料可能包含雜訊或錯誤讀數。一個AI資料處理工具被部署在資料流中以執行即時驗證。它使用訓練好的模型來識別超出預期操作範圍或模式的異常讀數。該工具可以自動標記、過濾甚至糾正這些異常值,然後再將它們輸入預測模型,從而防止誤報並確保維護警報的可靠性。
AI數據處理工具是為開發者設計的專用軟體,它利用人工智慧來自動化和增強資料準備任務。與依賴明確規則的傳統腳本或ETL工具不同,這些工具可以學習資料模式,從而智慧地清理、轉換、驗證複雜資料集,甚至從中生成特徵。它們旨在加速機器學習工作流程中最耗時的部分:準備高品質資料。
關鍵區別在於智慧性和適應性。傳統的ETL(擷取、轉換、載入)工具基於開發者設定的僵化、預定義的規則運作。如果資料格式改變,規則就會失效。而AI數據處理工具更具動態性。它們使用機器學習來實現:
主要用戶是直接使用資料來建構應用程式或模型的專業技術人員。這包括:
選擇合適的工具取決於您的具體需求。請考慮以下關鍵因素:
是的,許多先進的AI數據處理工具專門設計用於處理非結構化或半結構化資料。對於文字,它們提供基於NLP的清理(拼寫校正、停用詞移除)、實體識別和主題建模等功能。對於圖像,它們可能協助完成自動標記、調整大小或識別品質問題(如模糊度)等任務。這種能力是相對於傳統資料工具的一個顯著優勢,因為傳統工具通常僅限於處理結構化的表格資料。在選擇工具時,請核實其針對您所處理的非結構化資料類型的具體功能。