免费增值
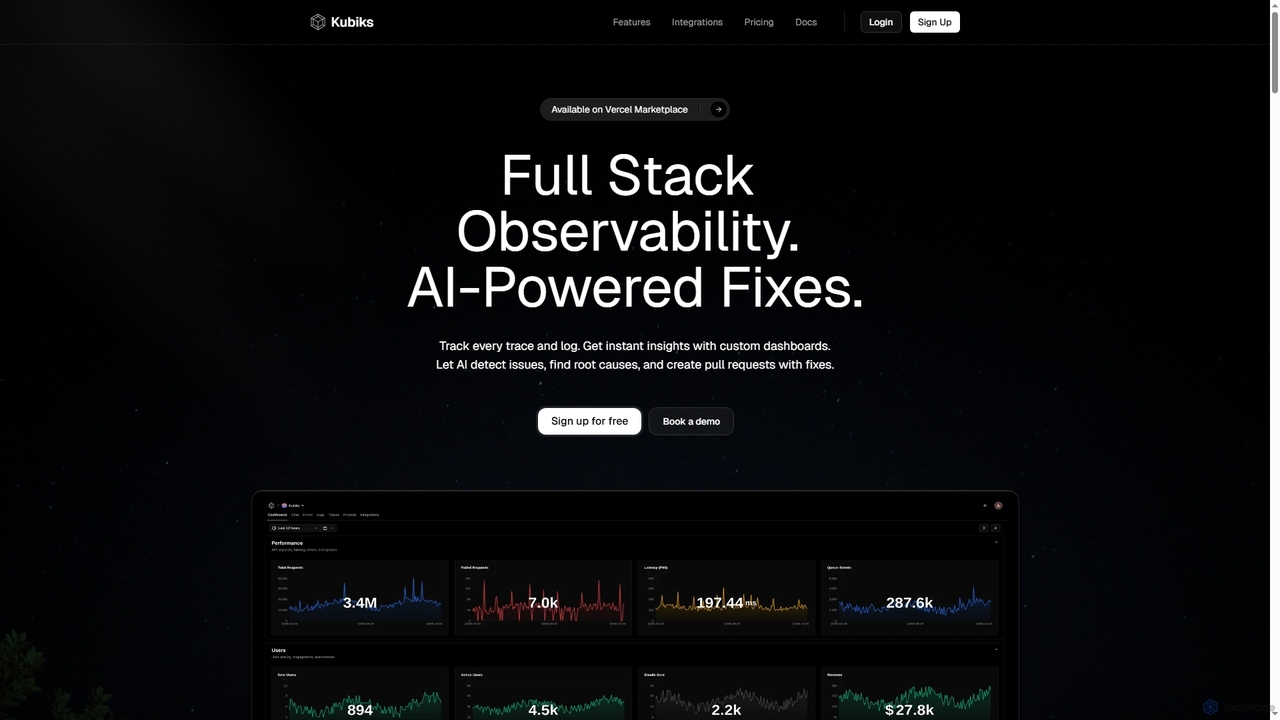
開發領域的可觀測性熱門 AI 工具包括 Kubiks 等,幫助您快速提升效率。
可觀測性是一套由AI驅動、以數據為核心的實踐和工具,透過檢查系統的外部輸出(日誌、指標和追蹤),使團隊能夠理解複雜系統的內部狀態。這些工具對於深入洞察軟體行為、性能和健康至關重要,尤其是在現代分散式架構中,這在軟體開發中非常普遍。透過提供全面的可見性,可觀測性解決方案賦能開發人員和維運團隊主動識別問題、快速診斷根本原因並優化系統性能,從而確保應用程式的健壯性和可靠性。
可觀測性工具對於管理複雜應用程式的軟體開發和維運團隊來說是不可或缺的。SRE(站點可靠性工程師)使用它們來維護系統正常運行時間,開發人員使用它們來調試微服務,產品經理使用它們來了解用戶體驗影響。這些工具提供必要的數據,以便就系統架構、資源分配和功能優先級做出明智的決策。
選擇可觀測性工具時,請考慮其數據收集能力(日誌、指標、追蹤)、與現有技術棧(雲提供商、程式語言、資料庫)的整合、處理不斷增長數據量的可擴展性,以及其視覺化和警報功能的品質。評估成本模型、易用性和社群支持,確保它與團隊的技術專長和預算相符。
對於軟體工程師和SRE(站點可靠性工程師)而言,可觀測性工具對於精確定位複雜微服務架構中的性能問題至關重要。透過使用分散式追蹤,團隊可以視覺化跨服務的整個請求流,識別是哪個特定服務或資料庫呼叫導致延遲,並快速深入查看相關日誌和指標以了解根本原因。這大大縮短了關鍵性能事件的平均解決時間(MTTR)。
DevOps和維運團隊利用可觀測性平台從被動式事件管理轉向主動式。AI驅動的異常檢測持續監控系統指標和日誌,以發現異常模式,例如錯誤率的突然飆升或意外的資源消耗。當檢測到異常時,會自動觸發警報,使團隊能夠在問題升級為中斷或嚴重影響最終用戶之前解決潛在問題。
產品經理和UX設計師可以利用可觀測性數據來深入了解用戶如何與他們的應用程式互動。透過將分散式追蹤與前端性能指標和用戶特定日誌關聯起來,他們可以重構用戶旅程,識別摩擦點,並理解後端性能對用戶體驗的影響。這些數據為產品改進和功能優先級排序提供了依據,從而帶來更令人滿意的用戶體驗。
基礎設施和雲架構師依賴可觀測性工具進行有效的容量規劃和資源優化。透過分析CPU使用率、記憶體消耗、網路流量和應用程式特定指標的歷史趨勢,團隊可以準確預測未來的資源需求。這可以防止資源過度配置(節省成本)或配置不足(避免性能下降),確保高效且可擴展的基礎設施管理。
安全營運(SecOps)團隊利用可觀測性平台進行深入的安全事件調查。集中式日誌聚合和分析功能使安全分析師能夠快速搜索大量系統和應用程式日誌,以查找可疑活動、未經授權的訪問嘗試或數據洩露。將這些日誌與網路追蹤和系統指標關聯起來,為取證分析提供了全面的時間線和上下文,有助於快速遏制和補救。
開發和發布工程團隊將可觀測性原則應用於其CI/CD管道。透過從構建伺服器、測試環境和部署過程中收集指標和日誌,他們可以識別瓶頸、緩慢的測試或失敗的部署。這種可見性有助於優化管道階段,減少構建時間,並確保更快、更可靠的軟體交付,直接提高開發人員生產力並縮短產品上市時間。
在軟體開發中,可觀測性是指透過檢查系統生成的數據(主要是日誌、指標和追蹤)來推斷系統內部狀態的能力。與通常關注已知故障模式的傳統監控不同,可觀測性旨在提供對未知問題的深入、上下文豐富的洞察。它對於理解複雜的分散式應用程式至關重要,使開發人員和SRE能夠調試、優化並確保其系統的可靠性。
儘管相關,但可觀測性和監控是不同的。監控告訴你系統是否在工作(例如,“CPU使用率高嗎?”)。可觀測性則告訴你它為什麼不工作或它是如何運行的(例如,“為什麼CPU使用率高,是哪個特定的微服務導致的?”)。監控通常依賴預定義的儀表板和警報來處理已知問題,而可觀測性則提供工具來探索、查詢和理解新穎的系統行為,這對於複雜的現代應用程式至關重要。
可觀測性的三大支柱通常被認為是日誌(Logs)、指標(Metrics)和追蹤(Traces)。日誌是系統中事件的離散、帶時間戳的記錄,對於詳細調試很有用。指標是隨時間推移的數據點聚合,提供系統健康和性能的數值表示(例如,CPU使用率、請求率)。追蹤表示請求透過分散式系統的端到端旅程,顯示跨多個服務的操作序列和時間。它們共同提供了系統行為的全面視圖。
廣泛的角色都受益於可觀測性工具。軟體開發人員使用它們進行調試、性能調優和理解生產環境中的程式碼行為。站點可靠性工程師(SRE)和DevOps團隊依靠它們進行事件響應、系統健康監控和維護服務水平目標(SLO)。產品經理則從中獲得用戶體驗和功能採用的洞察。最終,任何參與在複雜環境中構建、部署或操作軟體的團隊都能從增強的可見性中受益。
可觀測性透過實現更快的問題檢測、診斷和解決,顯著提高了系統可靠性。憑藉全面的日誌、指標和追蹤,團隊可以迅速識別問題的根本原因,通常在問題影響用戶之前。主動的異常檢測有助於防止中斷,而詳細的洞察則促進性能優化和資源管理。這導致停機時間減少、系統穩定性提高以及整體用戶體驗更好,直接有助於提高可靠性。