

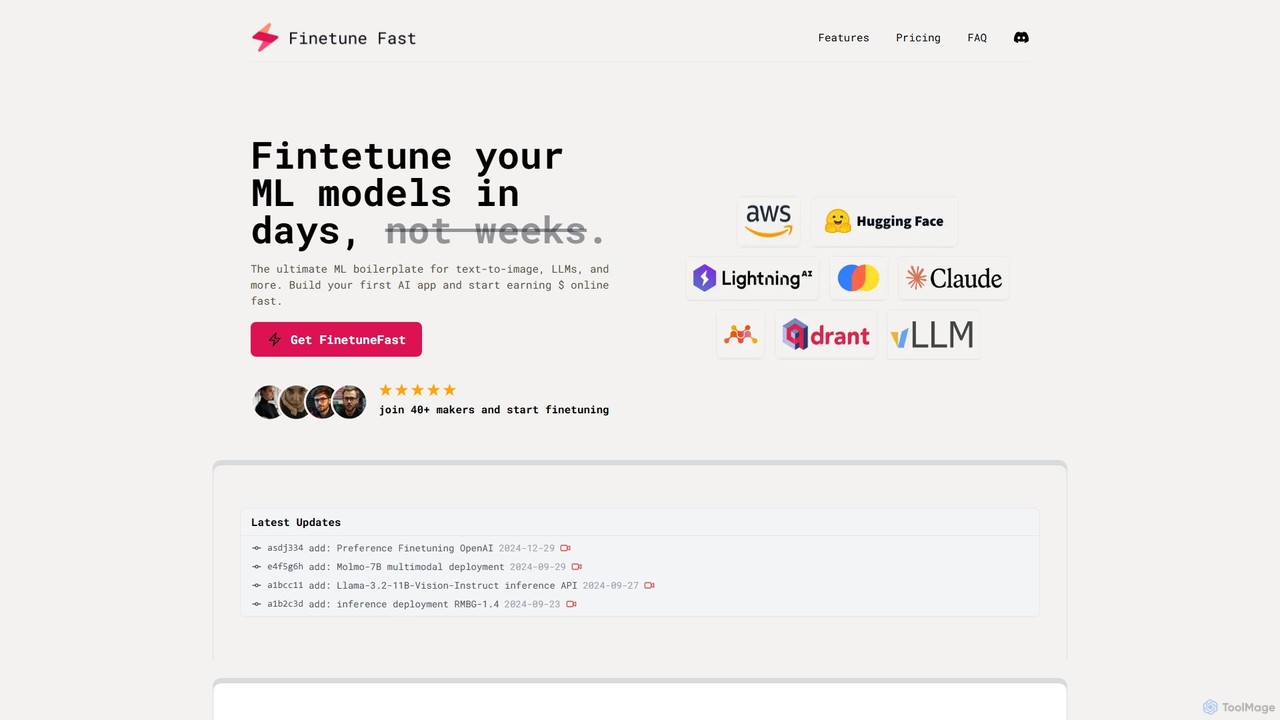
FinetuneFast Overview
FinetuneFast ist ein unverzichtbares Toolkit für ML-Ingenieure, Entwickler und Indie-Makers, die ihren KI-Entwicklungszyklus beschleunigen möchten. Es bietet eine umfassende Sammlung von ML-Boilerplates, die den gesamten Prozess von Modelltraining und Datenaufbereitung bis hin zu Bereitstellung und Skalierung optimieren. Die Kernmission von FinetuneFast, entwickelt vom erfahrenen ML- und SRE-Ingenieur Patrick, besteht darin, die repetitiven und zeitaufwändigen Aufgaben im Zusammenhang mit der Einrichtung von KI-Infrastruktur zu eliminieren, damit sich Entwickler auf das Wesentliche konzentrieren können: die Erstellung und Verfeinerung leistungsstarker KI-Modelle.
Die Plattform adressiert häufige Schwachstellen im ML-Workflow, wie das Konfigurieren von Umgebungen, das Bereinigen von Daten, die Integration von APIs und die Bereitstellung von Modellen. Durch die Bereitstellung vorkonfigurierter, produktionsreifer Lösungen behauptet FinetuneFast, Entwicklern bei einem typischen Projekt über 20 Arbeitsstunden zu ersparen und ein mehrwöchiges Unterfangen in eine Angelegenheit von Tagen zu verwandeln.
Wie man FinetuneFast verwendet
Die Verwendung von FinetuneFast ist für jeden mit Programmiererfahrung ein unkomplizierter Prozess. Nach dem Kauf eines Plans erhalten Sie innerhalb von 24 Stunden manuellen Zugriff auf ein privates GitHub-Repository. Dort finden Sie eine gut organisierte Sammlung von Boilerplates und Vorlagen. Der typische Arbeitsablauf ist wie folgt:
- Boilerplate auswählen: Wählen Sie die passende Vorlage für Ihr Projekt, sei es das Feintuning eines LLM wie Llama-3, eines Text-zu-Bild-Modells wie Flux-Schnell oder die Implementierung eines RAG-Systems (Retrieval-Augmented Generation).
- Einrichtung und Konfiguration: Befolgen Sie die detaillierte Dokumentation, um Ihre Umgebung einzurichten und die Skripte mit Ihren spezifischen Parametern und Datenpfaden zu konfigurieren.
- Datenaufbereitung: Nutzen Sie die effizienten Datenladepipelines, um Ihre Trainingsdaten vorzubereiten und zu formatieren.
- Modelltraining: Führen Sie die vorkonfigurierten Trainingsskripte aus. Die Boilerplates unterstützen Multi-GPU-Training und Hyperparameter-Optimierungstools, um die besten Ergebnisse zu erzielen.
- Bereitstellung: Sobald Ihr Modell feingetunt ist, verwenden Sie die Bereitstellungs-Boilerplates für eine Ein-Klick-Bereitstellung. Dies generiert einen skalierbaren API-Endpunkt für Ihr Modell, komplett mit Überwachung und Protokollierung.
- Support: Bei technischen Fragen bietet der 'All In'-Plan Zugang zu einer dedizierten Discord-Community für Unterstützung durch den Ersteller und andere Benutzer.
Kernfunktionen von FinetuneFast
- Feintuning-Boilerplates: Produktionsreife Skripte zum Feintuning verschiedener Modelle, einschließlich LLMs (OpenAI, Mistral, Llama-3.2), Text-zu-Bild-Modellen (Flux-Schnell) und Text-zu-Sprache (Fish-Speech).
- Inferenz- und Bereitstellungs-Boilerplates: Vereinfachte Ein-Klick-Bereitstellungslösungen zur Erstellung automatisch skalierender, produktionsreifer API-Endpunkte für Ihre Modelle.
- RAG-Beispiele und -Vorlagen: Gebrauchsfertige Vorlagen zum Aufbau fortschrittlicher Retrieval-Augmented Generation-Systeme, die es Modellen ermöglichen, auf externes Wissen zuzugreifen.
- Effiziente Datenpipelines: Optimierte Skripte zum Laden und Verarbeiten von Daten, ein kritischer, aber oft langwieriger Teil des ML-Prozesses.
- Multi-GPU-Unterstützung: Out-of-the-box-Unterstützung für das Training auf mehreren GPUs, was den Trainingsprozess erheblich beschleunigt.
- Inkludierte Best Practices: Der Code enthält Best Practices aus ML und SRE, um sicherzustellen, dass Ihre Modelle nicht nur leistungsstark, sondern auch zuverlässig und skalierbar sind.
Anwendungsfälle für FinetuneFast
FinetuneFast ist vielseitig und kann für eine breite Palette von Projekten verwendet werden:
- AI-SaaS-Produkte: Indie-Entwickler können schnell Nischen-AI-SaaS-Anwendungen erstellen und auf den Markt bringen, wie z. B. einen spezialisierten Inhaltsgenerator oder ein benutzerdefiniertes Bilderstellungstool.
- Benutzerdefinierte Chatbots: Unternehmen können ein Open-Source-LLM auf ihren internen Dokumenten feintunen, um eine private Wissensdatenbank oder einen Kundensupport-Bot zu erstellen.
- KI-Kunstgenerierung: Künstler und Designer können Bildmodelle auf ihren einzigartigen Stil feintunen, um konsistente und originelle Kunstwerke zu produzieren.
- Schnelles Prototyping: ML-Ingenieure können schnell neue Ideen testen und validieren, ohne sich mit der Einrichtung der zugrunde liegenden Infrastruktur aufzuhalten.
- Spezialisierte KI-Dienste: Erstellung spezifischer Tools wie Hintergrundentfernung (RMBG-1.4) oder multimodaler Anwendungen (Molmo-7B) mit den bereitgestellten Boilerplates.
Vorteile von FinetuneFast
Der Hauptvorteil von FinetuneFast ist die Geschwindigkeit. Es reduziert die Entwicklungszeit drastisch. Weitere wichtige Vorteile sind:
- Kosteneffektiv: Eine einmalige Zahlung gewährt Zugang zu allen Materialien für unbegrenzte Projekte, was es weitaus günstiger macht als abonnementbasierte Plattformen oder die Einstellung von Personal für die Einrichtung.
- Produktionsreif: Die Boilerplates sind nicht nur für akademische Übungen gedacht; sie sind darauf ausgelegt, realen Datenverkehr zu bewältigen und automatisch zu skalieren.
- Von Experten erstellt: Entwickelt von einem Ingenieur mit tiefgreifender Expertise in sowohl Machine Learning als auch Site Reliability Engineering (SRE), was hohe Qualitäts- und Zuverlässigkeitsstandards gewährleistet.
- Umfassende Lösung: Deckt den gesamten ML-Lebenszyklus ab, vom Training über die Bereitstellung bis zur Überwachung.
Preise und Pläne
FinetuneFast bietet ein einfaches Einmalzahlungsmodell.
- Starter-Plan: Preis $99.99 (im Angebot von $159.99). Dieser Plan enthält Feintuning-Boilerplates, produktionsreife Inferenz-Boilerplates, RAG-Beispiele und -Vorlagen sowie Best-Practices-Anleitungen.
- All-In-Plan: Preis $119.99 (im Angebot von $199.99). Dieser Plan enthält alles aus dem Starter-Plan sowie Zugang zur privaten Discord-Community für Support und lebenslange Updates für das Repository.
Beide Pläne bieten eine 'einmal zahlen, unbegrenzt Projekte erstellen'-Lizenz.
FinetuneFast Alternatives
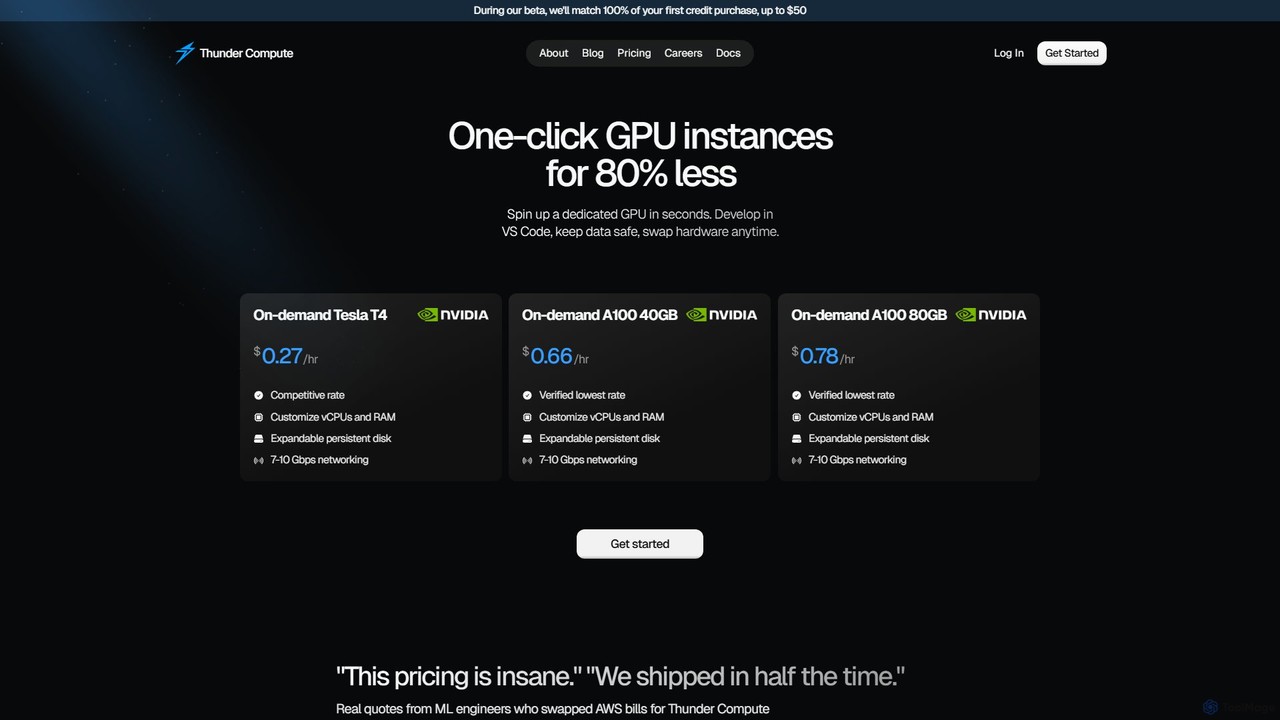
thundercompute
Thunder Compute bietet eine extrem kostengünstige GPU-Cloud-Plattform, die für KI- und Machine-Learning-Entwickler entwickelt wurde. Sie stellt On-Demand-GPU-Instanzen wie die NVIDIA A100 und T4 zu Preisen bereit, die bis zu 80 % niedriger sind als bei großen Cloud-Anbietern. Mit Funktionen wie Ein-Klick-Setup, VS-Code-Integration und nahtloser Skalierbarkeit vereinfacht es den Entwicklungsworkflow vom Prototyping bis zur Produktion drastisch und ermöglicht es Entwicklern, sich auf die Erstellung von Modellen statt auf die Verwaltung der Infrastruktur zu konzentrieren.
Maschinelles Lernen
Paperspace
Paperspace ist eine hochleistungsfähige Cloud-Computing-Plattform für KI und maschinelles Lernen. Sie bietet mühelosen Zugriff auf leistungsstarke Cloud-GPUs, verwaltete Jupyter-Notebooks und eine vollständige MLOps-Plattform (Gradient) zum Erstellen, Trainieren und Bereitstellen von Modellen. Ideal für Entwickler, Datenwissenschaftler und Unternehmen, die ihre KI-Workflows ohne die Komplexität der Infrastrukturverwaltung beschleunigen möchten.
Maschinelles Lernen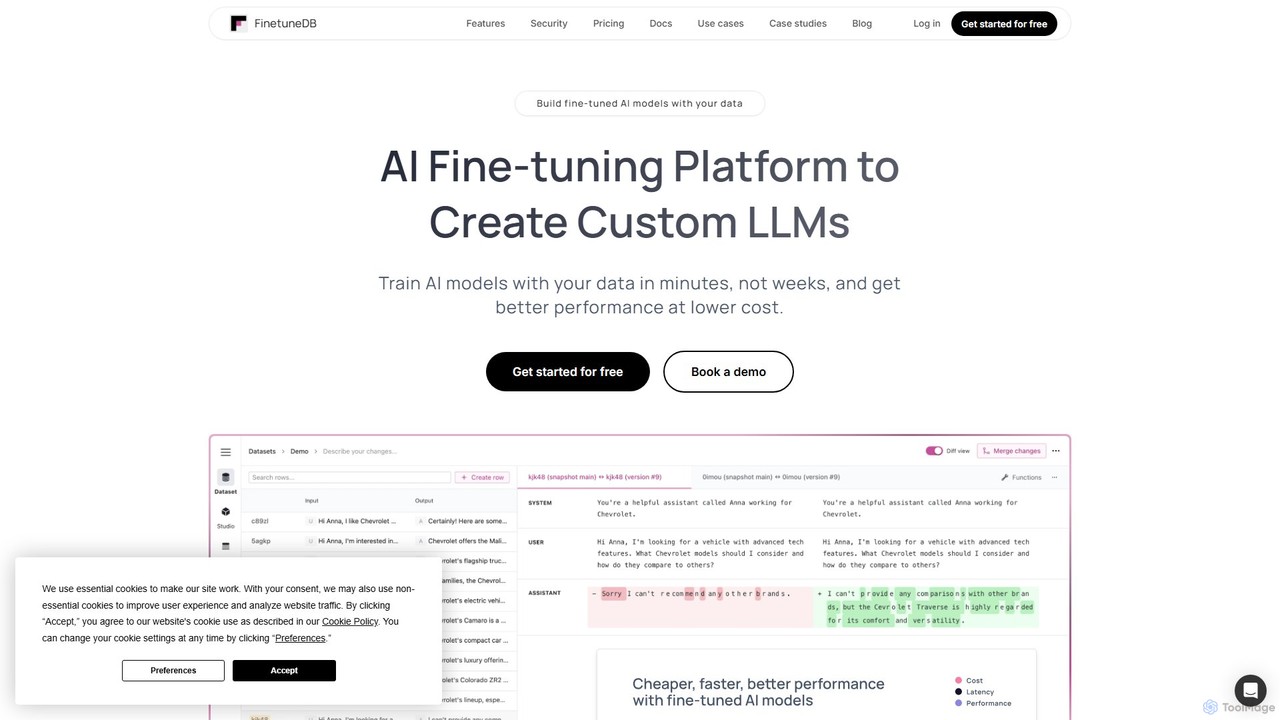
FinetuneDB
FinetuneDB ist eine All-in-One-KI-Fine-Tuning-Plattform für Entwickler. Sie vereinfacht den gesamten Workflow zur Erstellung benutzerdefinierter Large Language Models (LLMs), von der Erstellung hochwertiger Datensätze und dem Fine-Tuning von Modellen wie Llama 3 und GPT-4o mini bis hin zur Bereitstellung und kontinuierlichen Evaluierung auf einer einzigen, sicheren Plattform.
Llmops
Ollama
Ollama ist ein leistungsstarkes Open-Source-Framework zum lokalen Ausführen von großen Sprachmodellen (LLMs) wie Llama 3, Mistral und Gemma auf Ihrer eigenen Hardware. Verfügbar für macOS, Windows und Linux, vereinfacht es die Einrichtung und Verwaltung von Open-Source-Modellen und ermöglicht eine private, offline-fähige und kostengünstige KI-Entwicklung und -Nutzung.
Maschinelles Lernen
deepsense.ai
deepsense.ai ist ein führendes Unternehmen für KI-Beratung und kundenspezifische Softwareentwicklung. Sie sind darauf spezialisiert, maßgeschneiderte KI-Lösungen für Unternehmen zu entwickeln und nutzen dabei Expertise in LLMs, RAG, Computer Vision, MLOps und prädiktiver Analytik. Sie arbeiten mit Unternehmen und Start-ups zusammen, um KI in Produkte zu integrieren, Betriebsabläufe zu optimieren und durch fortschrittliche, produktionsreife KI-Systeme einen Wettbewerbsvorteil zu erzielen.
KI-BeratungFinetuneFast Categories
FinetuneFast Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
FinetuneDB
FinetuneDB ist eine All-in-One-KI-Fine-Tuning-Plattform für Entwickler. Sie vereinfacht den gesamten Workflow zur Erstellung benutzerdefinierter Large Language Models (LLMs), von der Erstellung hochwertiger Datensätze und dem Fine-Tuning von Modellen wie Llama 3 und GPT-4o mini bis hin zur Bereitstellung und kontinuierlichen Evaluierung auf einer einzigen, sicheren Plattform.
Llmops
AI News Hub
AI News Hub ist eine umfassende Plattform, die Echtzeit-KI-Ankündigungen, kuratierte Blog-Updates zu agentischer KI, RAG und Produktionstools bereitstellt. Sie bietet einen personalisierten Feed, Lesezeichenfunktionen und eine reichhaltige Sammlung von Lernressourcen, einschließlich Roadmaps, Kursen und Videos, um Entwickler und Enthusiasten in der sich schnell entwickelnden KI-Landschaft auf dem Laufenden und kompetent zu halten.
Aggregation
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
AutomatisierungOllama
Ollama ist ein leistungsstarkes Open-Source-Framework zum lokalen Ausführen von großen Sprachmodellen (LLMs) wie Llama 3, Mistral und Gemma auf Ihrer eigenen Hardware. Verfügbar für macOS, Windows und Linux, vereinfacht es die Einrichtung und Verwaltung von Open-Source-Modellen und ermöglicht eine private, offline-fähige und kostengünstige KI-Entwicklung und -Nutzung.
Maschinelles Lernendeepsense.ai
deepsense.ai ist ein führendes Unternehmen für KI-Beratung und kundenspezifische Softwareentwicklung. Sie sind darauf spezialisiert, maßgeschneiderte KI-Lösungen für Unternehmen zu entwickeln und nutzen dabei Expertise in LLMs, RAG, Computer Vision, MLOps und prädiktiver Analytik. Sie arbeiten mit Unternehmen und Start-ups zusammen, um KI in Produkte zu integrieren, Betriebsabläufe zu optimieren und durch fortschrittliche, produktionsreife KI-Systeme einen Wettbewerbsvorteil zu erzielen.
KI-Beratung
LAION
LAION (Large-scale Artificial Intelligence Open Network) ist eine gemeinnützige Organisation, die sich der Demokratisierung der KI-Forschung verschrieben hat. Sie stellt der Öffentlichkeit riesige Open-Source-Datensätze, vortrainierte Modelle und Werkzeuge zur Verfügung und fördert so offene Forschung, Bildung und eine ressourceneffiziente Entwicklung im maschinellen Lernen.
Datensätze
xTuring
xTuring ist eine Open-Source-Python-Bibliothek, die den Prozess des Erstellens, Feinabstimmens und Steuerns von Großen Sprachmodellen (LLMs) vereinfachen soll. Sie bietet eine benutzerfreundliche Oberfläche für Entwickler und Forscher, um KI-Modelle für spezifische Daten und Anwendungen mit hoher Effizienz und Anpassbarkeit zu personalisieren.
Modelltraining
hyperficient
hyperficient ist ein Open-Source-KI-Tool für Entwickler und ML-Ingenieure, das die Suche nach den effizientesten Feinabstimmungsstrategien für neuronale Netze automatisiert. Es reduziert Rechenkosten, GPU-Zeit und manuellen Aufwand erheblich und ermöglicht eine optimale Modellleistung bei begrenzten Ressourcen.
Bibliotheken
Firecrawl
Firecrawl ist eine Open-Source, entwicklerorientierte API, die jede Website in saubere, LLM-fähige Daten umwandelt. Es bewältigt alle Komplexitäten des Web-Scrapings, einschließlich JavaScript-Rendering, Proxy-Rotation und Ratenbegrenzungen, und ermöglicht es Ihnen, KI-Anwendungen, Agenten und RAG-Systeme mit zuverlässigen Web-Inhalten zu versorgen. Es bietet Scraping-, Crawling- und Suchfunktionen über eine einfache API.
Datenerfassung
Exa
Exa ist eine KI-native Suchmaschine und API, die für LLMs entwickelt wurde. Sie liefert hochwertige Echtzeit-Webdaten durch semantische Suche, Content-Crawling und agentenbasierte Forschungsfähigkeiten, um KI-Anwendungen zu betreiben, Halluzinationen zu reduzieren und Einblicke zu gewinnen, die traditionelle Suchmaschinen verpassen.
Suchmaschine
Together AI
Together AI ist eine führende Cloud-Plattform für Entwickler, die eine schnelle und kostengünstige Infrastruktur zum Ausführen, Feinabstimmen und Trainieren von Open-Source-Generative-AI-Modellen bereitstellt. Sie bietet eine umfangreiche Bibliothek mit über 200 Modellen, serverlose Inferenz-APIs, anpassbares Fine-Tuning und dedizierte GPU-Cluster und schafft so eine End-to-End-Lösung für die Erstellung und Skalierung von KI-Anwendungen.
GPU-Infrastruktur
Pinecone
Pinecone ist eine hochleistungsfähige, vollständig verwaltete Vektordatenbank, die für die Erstellung von wissensbasierten KI-Anwendungen im großen Maßstab entwickelt wurde. Sie ermöglicht Entwicklern die Implementierung fortschrittlicher Funktionen wie semantische Suche, Retrieval-Augmented Generation (RAG) und personalisierte Empfehlungen durch effizientes Speichern und Abfragen von Milliarden von Vektor-Embeddings in Echtzeit.
Datenbank
Milvus
Milvus ist eine leistungsstarke Open-Source-Vektordatenbank, die für KI-Anwendungen entwickelt wurde. Sie ermöglicht Entwicklern, Milliarden von hochdimensionalen Vektoren mit minimaler Latenz zu verwalten und zu durchsuchen. Ideal für den Aufbau skalierbarer Systeme wie Retrieval-Augmented Generation (RAG), Empfehlungssysteme und semantische Suche, bietet Milvus flexible Bereitstellungsoptionen vom lokalen Prototyping bis hin zu großen verteilten Clustern.
Maschinelles Lernen
Jina AI
Jina AI bietet eine hochmoderne Search Foundation-Plattform mit einer Suite leistungsstarker APIs für multimodale Einbettungen, Reranking und Datenextraktion. Sie wurde für Entwickler und Unternehmen entwickelt, um hochwertige, zuverlässige generative KI, RAG (Retrieval-Augmented Generation) und fortschrittliche Suchanwendungen mit mehrsprachigen und multimodalen Fähigkeiten zu erstellen.
Sprachmodell
Mastra
Mastra ist ein Open-Source-TypeScript-Framework, das für Entwickler konzipiert wurde, um anspruchsvolle KI-Agenten und komplexe Workflows zu erstellen, bereitzustellen und zu verwalten. Es bietet ein entwicklerfreundliches SDK mit Funktionen wie persistentem Speicher, Tool-Aufrufen, Retrieval-Augmented Generation (RAG) und deterministischen Workflow-Graphen. Entwickelt vom Team hinter Gatsby, vereinfacht Mastra die Erstellung von produktionsreifen KI-Anwendungen im JavaScript-Ökosystem.
Agenten-Builder
FinetuneFast Comments (0)
Sign in to comment.
AnmeldenNo comments yet.