
DataChain Overview
DataChain est une plateforme open-source avancée conçue pour relever les défis des "Heavy Data" — les données riches, multimodales et non structurées qui alimentent la prochaine génération d'IA. Développée par l'équipe derrière le populaire DVC (Data Version Control), DataChain offre une solution complète pour la curation, l'enrichissement et le versionnement d'ensembles de données massifs tels que des vidéos, des images, des fichiers audio et des PDF qui résident généralement dans des stockages d'objets comme S3, GCS ou Azure.
La plateforme est construite avec une philosophie axée sur le développeur, permettant aux équipes de transformer des fichiers bruts et non structurés en connaissances prêtes pour l'IA. Elle permet l'extraction de structure, d'embeddings et d'informations critiques, essentielles pour alimenter des agents d'IA sophistiqués, des copilotes et des flux de travail adaptatifs. En transformant les données lourdes en un avantage concurrentiel, DataChain aide les équipes à construire des pipelines de données efficaces et puissants sans avoir besoin de retraiter constamment les données.
Comment utiliser DataChain
DataChain propose un flux de travail simplifié et centré sur le code qui s'intègre de manière transparente dans l'environnement existant d'un développeur.
- Développer localement : Commencez par définir vos pipelines de traitement de données en utilisant du code Python simple directement dans votre environnement de développement intégré (IDE) local. Cette approche intuitive élimine le besoin de requêtes SQL complexes ou de langages spécialisés.
- Se connecter aux sources de données : Connectez-vous à vos données non structurées stockées dans S3, GCS, Azure ou tout autre stockage d'objets. DataChain fonctionne avec une architecture sans copie, ce qui signifie qu'il suit les versions et les références sans dupliquer vos fichiers volumineux, économisant ainsi des coûts de stockage et du temps considérables.
- Traiter et enrichir : Appliquez des grands modèles de langage (LLM) et des modèles d'apprentissage automatique (ML) personnalisés à vos données pour extraire des informations, générer des embeddings et structurer vos informations. Cela peut inclure des tâches comme la transcription audio, la détection d'objets sur des vidéos ou l'analyse de texte à partir de PDF.
- Versionner et suivre : DataChain crée automatiquement un registre de jeux de données centralisé qui suit la lignée complète des données, y compris toutes les dépendances de code et de données. Cela garantit que chaque jeu de données est versionné, auditable et entièrement reproductible.
- Mettre à l'échelle dans le cloud : Une fois votre pipeline testé localement, vous pouvez le déployer dans le cloud et le mettre à l'échelle sur des centaines de GPU sans aucune refonte. La plateforme gère le traitement distribué et la mise à l'échelle automatique, traitant efficacement des millions, voire des milliards de fichiers.
- Accéder et interroger : Les jeux de données versionnés et structurés peuvent être consultés et interrogés via une interface utilisateur web, des interfaces de chat, des IDE ou directement par des agents d'IA via l'API de la plateforme.
Fonctionnalités principales de DataChain
- Registre de jeux de données centralisé : Fournit une source unique de vérité pour tous vos jeux de données avec une lignée complète, des métadonnées et un versionnement.
- Simplicité de Python avec l'échelle de SQL : Utilisez une interface Python unique et intuitive pour toutes les opérations de données, ce qui la rend facile pour les développeurs et plus compatible avec les IDE et les agents.
- IDE local et mise à l'échelle dans le cloud : La manière la plus productive de construire des pipelines de données — développez et testez localement, puis mettez à l'échelle de manière transparente vers une infrastructure cloud massive.
- Zéro copie de données, zéro verrouillage : Vos données restent dans votre propre stockage. DataChain ne gère que les métadonnées et les versions, évitant ainsi le verrouillage par un fournisseur et réduisant les coûts.
- Traitement de données multimodales : Gère et traite nativement divers types de données non structurées, y compris les vidéos, les PDF, l'audio et les images.
- Traitement de données à grande échelle : Conçu pour gérer efficacement des millions ou des milliards de fichiers, filtrer les données à l'aide de modèles de ML et calculer facilement les mises à jour des jeux de données.
- Reproductibilité et lignée des données : Suivez automatiquement toutes les dépendances pour reproduire n'importe quelle version d'un jeu de données et les mettre à jour automatiquement via des processus ETL.
- Traitement parallèle et distribué : Tire parti de l'infrastructure cloud moderne pour un traitement de données parallèle à grande vitesse.
Cas d'utilisation pour DataChain
DataChain est polyvalent et peut être appliqué à un large éventail de défis en IA et en ingénierie des données :
- Affinage de modèles multimodaux : Préparez et versionnez des ensembles de données complexes pour l'affinage de modèles comme CLIP afin de faire correspondre des images à des légendes textuelles.
- Traitement de documents à grande échelle : Construisez des pipelines pour extraire et analyser du texte à partir de millions de documents (par exemple, des PDF) et créer des embeddings vectoriels pour les systèmes RAG (Génération Augmentée par Récupération).
- IA générative pour la vision par ordinateur : Créez, curez et gérez les vastes ensembles de données nécessaires à l'entraînement et à l'évaluation des modèles de vision par ordinateur génératifs.
- Alimenter les agents d'IA et les copilotes : Fournissez des données fiables, versionnées et structurées pour garantir que les agents d'IA et les copilotes fonctionnent avec des informations précises et à jour.
- Curation et filtrage de données : Utilisez des modèles de ML pour filtrer, étiqueter et sélectionner par programmation les données les plus précieuses à partir d'énormes collections brutes.
Avantages de DataChain
DataChain offre un avantage distinct pour les équipes travaillant avec des systèmes d'IA modernes :
- Efficacité : L'architecture sans copie et le traitement évolutif réduisent considérablement le temps et les coûts associés à la préparation des données.
- Centré sur le développeur : L'approche native de Python abaisse la barrière à l'entrée et augmente la productivité des équipes de développement.
- Robustesse et reproductibilité : Garantit que tout le travail sur les données est versionné et reproductible, ce qui est essentiel pour les applications d'IA d'entreprise.
- Fondation open-source : Construit sur un noyau open-source puissant, offrant transparence, flexibilité et une communauté solide.
- D'une équipe de confiance : Développé par les créateurs de DVC, un outil largement respecté dans la communauté MLOps, garantissant une compréhension approfondie des défis de la gestion des données en ML.
Tarification et plans
DataChain propose un modèle de tarification flexible et à plusieurs niveaux pour répondre à différents besoins :
- Open Source : Un plan gratuit et auto-hébergé qui inclut toutes les fonctionnalités de base comme le support du stockage non structuré, le versionnement et la lignée des données, la recherche sémantique, les pipelines Python et le traitement parallèle. Il convient aux données à l'échelle du téraoctet et jusqu'à 30 millions d'éléments.
- Teams (SaaS) : Une offre cloud gérée conçue pour les équipes. Elle inclut tout ce qui se trouve dans l'Open Source plus des fonctionnalités pour les données à l'échelle du pétaoctet (1 milliard d'éléments et plus), le traitement distribué, la mise à l'échelle automatique, un registre de jeux de données partagé avec une interface utilisateur web, SSO/SAML et RBAC. La tarification est disponible en contactant le service commercial.
- Enterprise : Pour les grandes organisations ayant des besoins spécifiques en matière de sécurité et de déploiement. Ce plan inclut toutes les fonctionnalités du plan Teams plus des options pour le Bring Your Own Cloud (BYOC) et les déploiements sur site (on-premise). La tarification est disponible en contactant le service commercial.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 3.8K
- 2026-1: 5.3K
- 2026-2: 4.5K
- 2026-3: 6.0K
- 2026-4: 3.2K
- 2026-5: 4.4K
Geography
Top 5 countries / regions
- 🇺🇸États-Unis52.3%
- 🇷🇺Russie19.7%
- 🇮🇳Inde13.2%
- 🇩🇪Allemagne12.2%
- 🇪🇸Espagne2.6%
Top keywords
| Keyword | Cost per click |
|---|---|
| chemin ai | $0.00 |
| claude structured output | $0.00 |
| data chain | $0.00 |
| datachain | $0.00 |
| unstructured io | $1.63 |
DataChain Alternatives
Tidepool
Tidepool (anciennement Aquarium) était une puissante plateforme MLOps conçue pour les équipes d'IA afin d'améliorer les modèles d'apprentissage automatique. Elle était spécialisée dans la gestion et la curation d'ensembles de données pour la vision par ordinateur et le NLP, permettant une itération plus rapide et des performances de modèle plus élevées grâce à une approche centrée sur les données.
Apprentissage automatique
PremAI
PremAI est une plateforme de niveau entreprise pour construire, affiner et déployer des modèles d'IA sécurisés et privés. Elle permet aux entreprises de transformer leurs données brutes en modèles spécialisés et performants tout en conservant une souveraineté absolue sur les données et en utilisant un cryptage de pointe pour une confidentialité maximale.
Base de données
Ollama
Ollama est un puissant framework open-source pour exécuter localement de grands modèles de langage (LLM) comme Llama 3, Mistral et Gemma sur votre propre matériel. Disponible pour macOS, Windows et Linux, il simplifie la configuration et la gestion des modèles open-source, permettant un développement et une utilisation de l'IA privés, hors ligne et rentables.
Apprentissage automatique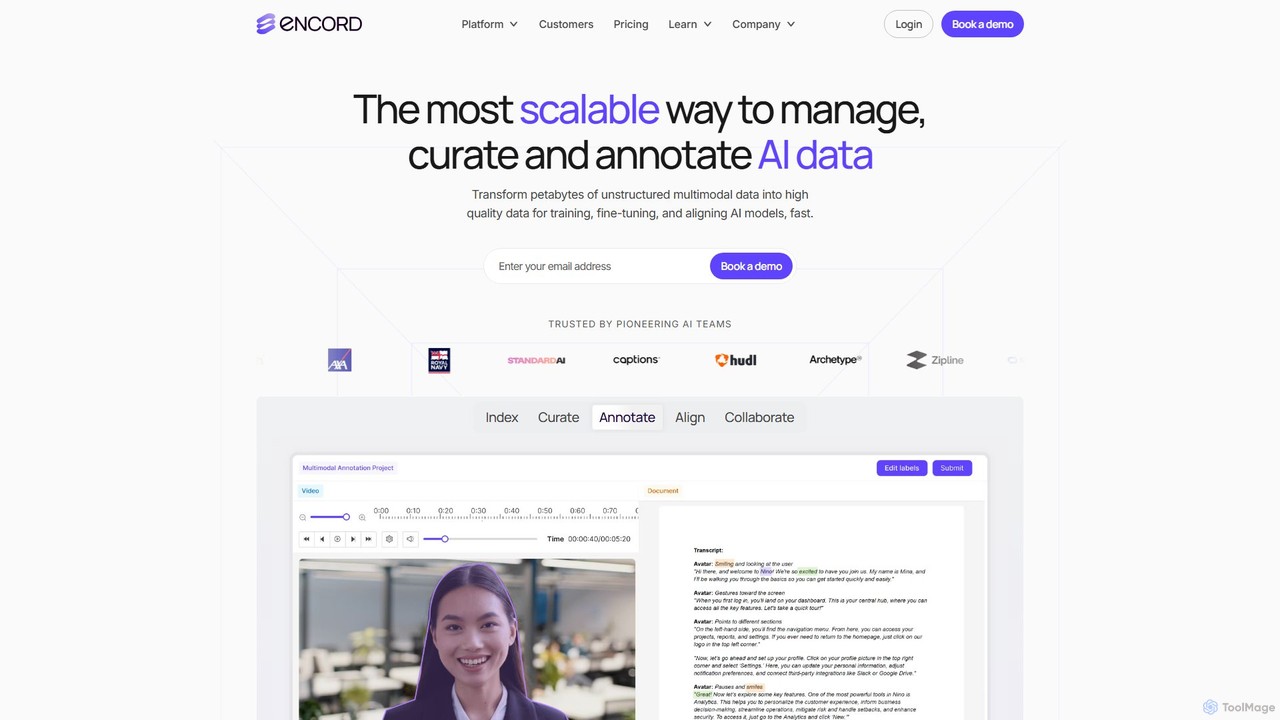
Encord
Encord est une plateforme complète de développement de données pour l'IA visuelle et multimodale. Elle fournit des outils pour gérer, organiser et annoter des données non structurées à grande échelle, telles que des images, des vidéos et des fichiers DICOM. La plateforme aide les équipes d'IA à créer des jeux de données de haute qualité, à améliorer les performances des modèles et à accélérer le déploiement d'applications d'IA prêtes pour la production grâce à un étiquetage avancé, une évaluation de modèle et des flux de travail avec intervention humaine.
Annotation
Baseten
Baseten est une plateforme d'inférence de qualité production pour déployer, mettre à l'échelle et gérer des modèles d'IA. Elle offre des runtimes haute performance, des flux de travail de développeur fluides et des options de déploiement flexibles (cloud, auto-hébergé, hybride). Idéal pour les équipes d'ingénierie et de ML qui construisent des applications d'IA critiques.
DéploiementDataChain Categories
DataChain Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools

MLflow
MLflow est une plateforme open source pour gérer le cycle de vie de l'apprentissage automatique de bout en bout. Elle permet aux développeurs et aux data scientists de suivre les expériences, de packager le code en exécutions reproductibles, de versionner et de partager les modèles, et de les déployer en production, en prenant en charge à la fois le ML traditionnel et les applications GenAI modernes.
Science des données
Dagster
Dagster est un orchestrateur de données moderne et open-source conçu pour construire, mettre à l'échelle et observer les pipelines de données et d'IA. Il agit comme un plan de contrôle unifié, permettant aux équipes de modéliser les actifs de données, de suivre la lignée et d'assurer la qualité des données en toute confiance. En intégrant les meilleures pratiques de l'ingénierie logicielle comme les tests locaux et les composants réutilisables, Dagster aide les ingénieurs de données et les équipes de ML à livrer des produits plus rapidement et de manière plus fiable.
Opérations de Machine Learning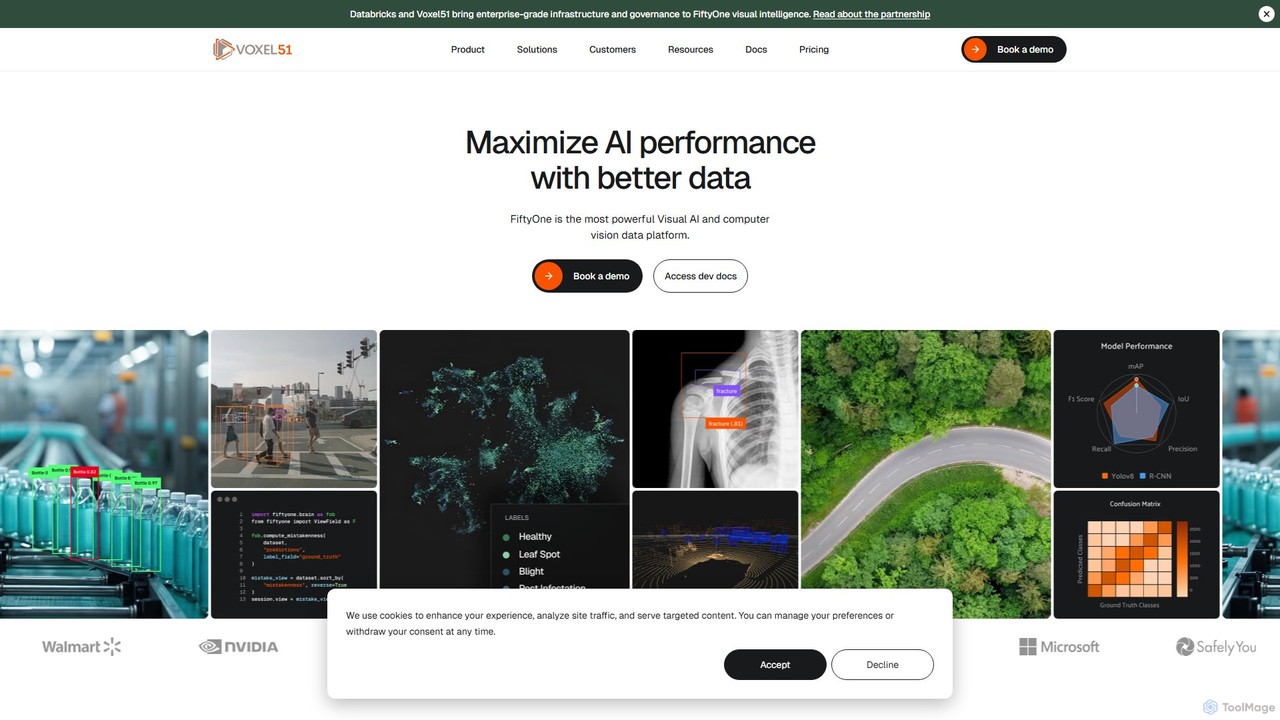
Voxel51
Voxel51 fournit FiftyOne, une plateforme de vision par ordinateur et d'IA multimodale de niveau entreprise. Elle permet aux développeurs et aux data scientists de curer, visualiser et évaluer des ensembles de données complexes, menant à des modèles plus performants. En se concentrant sur une IA centrée sur les données, FiftyOne rationalise les flux de travail pour l'annotation de données, l'amélioration de la qualité et l'analyse de modèles, accélérant ainsi l'ensemble du cycle de vie du développement.
MLOps
Flyte
Flyte est une plateforme d'orchestration de flux de travail open-source et native du cloud, conçue pour construire, déployer et gérer des pipelines de données, de machine learning et d'analyse de qualité production. Elle met l'accent sur la scalabilité, la reproductibilité et la facilité d'utilisation, permettant aux équipes de passer en toute transparence du développement local à la production à grande échelle. Avec un SDK Python-first et un support pour plusieurs langages, Flyte permet aux data scientists et aux ingénieurs de créer des flux de travail complexes, versionnés et maintenables.
MLOps
Union.ai
Union.ai est une plateforme de niveau entreprise, prête pour la production, pour orchestrer des flux de travail complexes d'IA et d'apprentissage automatique. Basée sur l'open-source Flyte, elle permet aux équipes de construire, servir et mettre à l'échelle des systèmes d'IA composés avec des performances et une efficacité inégalées. Elle comble le fossé entre les données et le ML, optimise les coûts du cloud avec des fonctionnalités comme le 'scale-to-zero', et améliore la vélocité des développeurs grâce à une expérience intégrée et transparente.
Orchestration
Jyek
Jyek est une plateforme d'agent IA qui comprend les objectifs, crée des plans d'exécution, utilise des outils et fournit des résultats vérifiables pour les tâches complexes à étapes multiples.
Automatisation
Metaflow
Un framework Python centré sur l'humain, originaire de Netflix, pour construire et gérer des projets de science des données, de ML et d'IA en conditions réelles. Il simplifie l'orchestration des flux de travail, la gestion des données et le déploiement de modèles, permettant un prototypage rapide et des pipelines de production évolutifs.
MLOps
Graphlit
Graphlit est une plateforme d'API de connaissances axée sur les développeurs pour la création d'applications et d'agents IA. Elle rationalise l'ingestion, la mémoire et la récupération de données non structurées de n'importe quelle source, offrant une puissante solution RAG-as-a-Service. Avec des SDK pour les principaux langages et des outils pour l'intégration d'agents IA, elle simplifie la création de systèmes IA sophistiqués.
Chiffon
Eventual
Eventual construit l'avenir de l'infrastructure de données avec Daft, un moteur de requête open-source haute performance pour les données multimodales. Il permet aux ingénieurs de traiter des images, des vidéos, de l'audio et du texte à l'échelle du pétaoctet avec la simplicité de SQL, accélérant considérablement les flux de travail d'IA et de ML sans nécessiter une expertise approfondie des systèmes distribués.
Apprentissage AutomatiqueTidepool
Tidepool (anciennement Aquarium) était une puissante plateforme MLOps conçue pour les équipes d'IA afin d'améliorer les modèles d'apprentissage automatique. Elle était spécialisée dans la gestion et la curation d'ensembles de données pour la vision par ordinateur et le NLP, permettant une itération plus rapide et des performances de modèle plus élevées grâce à une approche centrée sur les données.
Apprentissage automatiqueOllama
Ollama est un puissant framework open-source pour exécuter localement de grands modèles de langage (LLM) comme Llama 3, Mistral et Gemma sur votre propre matériel. Disponible pour macOS, Windows et Linux, il simplifie la configuration et la gestion des modèles open-source, permettant un développement et une utilisation de l'IA privés, hors ligne et rentables.
Apprentissage automatiqueEncord
Encord est une plateforme complète de développement de données pour l'IA visuelle et multimodale. Elle fournit des outils pour gérer, organiser et annoter des données non structurées à grande échelle, telles que des images, des vidéos et des fichiers DICOM. La plateforme aide les équipes d'IA à créer des jeux de données de haute qualité, à améliorer les performances des modèles et à accélérer le déploiement d'applications d'IA prêtes pour la production grâce à un étiquetage avancé, une évaluation de modèle et des flux de travail avec intervention humaine.
AnnotationBaseten
Baseten est une plateforme d'inférence de qualité production pour déployer, mettre à l'échelle et gérer des modèles d'IA. Elle offre des runtimes haute performance, des flux de travail de développeur fluides et des options de déploiement flexibles (cloud, auto-hébergé, hybride). Idéal pour les équipes d'ingénierie et de ML qui construisent des applications d'IA critiques.
Déploiement
deepchecks
Deepchecks est une plateforme de bout en bout pour évaluer, valider et surveiller les applications basées sur les LLM. Elle aide les équipes d'IA à définir, mesurer et valider les progrès de l'IA, garantissant la publication d'applications fiables et de haute qualité en rationalisant les tests du développement à la production, en passant par le CI/CD.
Analyse
Lightly
Lightly est une suite complète de vision par ordinateur pour les équipes de machine learning. Elle rationalise l'ensemble du cycle de vie du développement de modèles, de la curation et de la sélection intelligentes des données sur les appareils en périphérie (edge) au pré-entraînement et à l'ajustement fins, efficaces et sans étiquettes. En se concentrant sur les données les plus précieuses, Lightly aide à construire plus rapidement des modèles d'IA plus précis et prêts pour la production, tout en réduisant considérablement les coûts d'étiquetage et de stockage des données.
Gestion des Données
DataChain Comments (0)
Sign in to comment.
ConnexionNo comments yet.