
Raven Overview
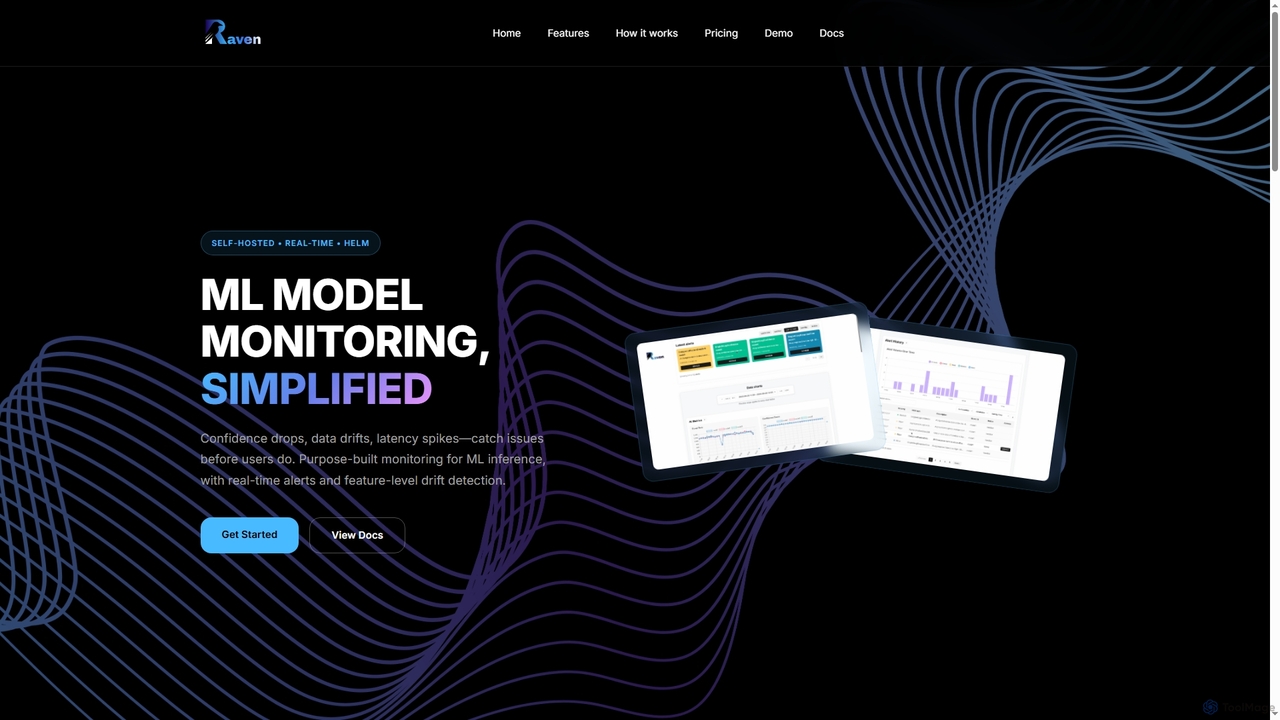
Raven est une plateforme de surveillance de modèles d'apprentissage automatique (ML) auto-hébergée et en temps réel, conçue spécifiquement pour simplifier l'observabilité des pipelines d'IA. Elle identifie de manière proactive les problèmes tels que les baisses de confiance, les dérives de données et les pics de latence en temps réel, les empêchant d'affecter les utilisateurs finaux. Contrairement aux outils de surveillance de serveurs traditionnels, Raven se concentre spécifiquement sur les performances et le comportement des modèles ML, fournissant des informations approfondies sur leurs processus d'inférence et garantissant la confiance en production.
Comment utiliser Raven
Les utilisateurs intègrent Raven en ajoutant une seule ligne de code (à l'aide des SDK Python ou JVM) dans leur code d'inférence ML pour commencer à envoyer des journaux. Une fois intégré, les tableaux de bord en temps réel se mettent à jour avec les requêtes entrantes, permettant aux utilisateurs de surveiller des métriques clés telles que la confiance, la latence, le débit et le mélange de sortie par modèle, par minute. Lorsque des problèmes tels que la dérive des données ou la dégradation des performances sont détectés, Raven envoie des alertes instantanées via Slack ou e-mail, permettant aux équipes d'optimiser rapidement leurs modèles en fonction d'informations exploitables. La plateforme est déployée via un graphique Helm, ce qui la rend compatible avec Kubernetes et installable en quelques minutes dans votre propre environnement.
Fonctionnalités principales de Raven
- Surveillance en temps réel de la confiance, de la latence, du débit et du mélange de sortie par modèle, par minute.
- Déploiement auto-hébergé à l'aide de graphiques Helm, garantissant que les données restent dans le cluster Kubernetes de l'utilisateur.
- Détection automatisée de la dérive pour identifier les écarts par rapport au comportement attendu du modèle.
- Notifications d'alerte instantanées via Slack ou e-mail pour les problèmes détectés.
- Graphiques rapides et rétention des données historiques alimentés par ClickHouse.
- SDKs conviviaux pour les développeurs (Python et JVM) pour une intégration facile avec le code d'inférence.
- Prise en charge de différents types de bundles (Compact pour le faible trafic, Enterprise pour le trafic élevé) et de types de licence (Community, Plus, Enterprise).
Cas d'utilisation pour Raven
Raven est idéal pour toute organisation déployant des modèles ML en production, en particulier pour les applications critiques où la fiabilité et les performances du modèle sont primordiales. Cela inclut :
- Détection de Fraude : Surveillance des modèles pour s'assurer qu'ils identifient avec précision les activités frauduleuses et ne dérivent pas avec le temps.
- Moteurs de Recommandation : Suivi des performances du modèle pour maintenir des recommandations utilisateur pertinentes et efficaces.
- Applications basées sur les LLM : S'assurer que les grands modèles de langage fonctionnent comme prévu, en détectant des problèmes tels que les pics de temps de réponse ou les sorties inattendues.
- Tout scénario nécessitant une observabilité robuste et en temps réel pour les pipelines d'IA afin de prévenir les défaillances silencieuses des modèles et de maintenir la confiance des utilisateurs.
Avantages de Raven
Raven offre plusieurs avantages clés aux équipes ML :
- Conçu spécifiquement pour le ML : Spécialement conçu pour l'inférence ML, offrant des informations plus approfondies et plus pertinentes que les outils de surveillance génériques.
- Détection des Problèmes en Temps Réel : Capture instantanément les problèmes tels que la dérive des données et la dégradation des performances, avant que les utilisateurs ne soient affectés.
- Auto-hébergé et Confidentialité des Données : Maintient les données sensibles du modèle dans le propre cluster de l'utilisateur, garantissant le contrôle, la sécurité et la conformité.
- Intégration et Déploiement Faciles : Des modifications de code minimales avec les SDK et un déploiement rapide via le graphique Helm simplifient la configuration.
- Alertes Exploitables : Fournit des notifications opportunes pour permettre une optimisation rapide et la résolution des problèmes.
- Évolutivité : Offre différents bundles (Compact, Enterprise) et types de licence pour répondre à diverses charges de trafic et exigences de fonctionnalités.
Tarification et plans
Raven propose des plans tarifaires flexibles :
- Gratuit / Test : 0 $. Comprend les métriques de base et le tableau de bord, l'ingestion HTTP + ClickHouse, la détection de dérive et les alertes Slack/E-mail.
- Pro : 199 $/mois. Conçu pour les environnements prêts pour la production, avec un débit moyen. Comprend les métriques de base et le tableau de bord, l'ingestion HTTP + ClickHouse, la détection de dérive et les notifications Slack/E-mail.
- Enterprise : Bientôt disponible. Ce plan est conçu pour un débit et une échelle élevés, offrant une évolutivité infinie et toutes les fonctionnalités du type de licence Plus.
Raven FAQ
Raven Alternatives
PloyD
PloyD est une plateforme d'opérations d'IA d'entreprise conçue pour rationaliser la mise en production des modèles et applications d'IA. Elle s'attaque aux défis courants tels que les goulots d'étranglement de la vitesse des développeurs, la complexité de l'infrastructure, l'efficacité de l'équipe et la conformité en matière de sécurité, permettant aux organisations de déployer, gérer et faire évoluer les solutions d'IA avec confiance et rapidité.
Systèmes RAG
Openlayer
Openlayer est une plateforme d'évaluation et d'observabilité de l'IA de niveau entreprise. Elle permet aux équipes de tester, surveiller et gouverner les modèles de machine learning traditionnels et les grands modèles de langage (LLM) tout au long de leur cycle de vie, du développement à la production, garantissant ainsi fiabilité et conformité.
Analyse
Nebius
Nebius est une plateforme cloud haute performance spécialement conçue pour les charges de travail exigeantes en IA et en Machine Learning. Elle offre un accès évolutif aux derniers GPU NVIDIA, des instances uniques aux clusters massifs, complété par une suite de services gérés et un AI Studio intégré pour rationaliser l'ensemble du cycle de vie du ML, de la formation à l'inférence.
Cloud GPU
UltiHash
UltiHash est une plateforme de stockage d'objets haute performance, native de Kubernetes, spécialement conçue pour les charges de travail d'IA et de big data. Elle offre un accès aux données ultra-rapide, des économies de coûts significatives grâce à une déduplication avancée au niveau de l'octet, et un déploiement flexible dans des environnements cloud, sur site ou hybrides. Son API compatible S3 assure une intégration transparente avec les piles de données et les flux de travail d'IA existants.
Opérations de Machine Learning
Truefoundry
Truefoundry est une plateforme d'entreprise pour le déploiement, la gestion et la mise à l'échelle d'applications d'IA agentique. Elle fournit une passerelle IA unifiée pour orchestrer des flux de travail IA complexes, gérer les modèles et garantir la sécurité, la gouvernance et l'observabilité. Conçue pour les développeurs et les équipes MLOps, elle prend en charge les déploiements sur site, dans le cloud et hybrides, optimisant l'utilisation des GPU et accélérant la mise sur le marché.
Cloud computingRaven Categories
Raven Jobs
Raven Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
PloyD
PloyD est une plateforme d'opérations d'IA d'entreprise conçue pour rationaliser la mise en production des modèles et applications d'IA. Elle s'attaque aux défis courants tels que les goulots d'étranglement de la vitesse des développeurs, la complexité de l'infrastructure, l'efficacité de l'équipe et la conformité en matière de sécurité, permettant aux organisations de déployer, gérer et faire évoluer les solutions d'IA avec confiance et rapidité.
Systèmes RAGOpenlayer
Openlayer est une plateforme d'évaluation et d'observabilité de l'IA de niveau entreprise. Elle permet aux équipes de tester, surveiller et gouverner les modèles de machine learning traditionnels et les grands modèles de langage (LLM) tout au long de leur cycle de vie, du développement à la production, garantissant ainsi fiabilité et conformité.
Analyse
Jyek
Jyek est une plateforme d'agent IA qui comprend les objectifs, crée des plans d'exécution, utilise des outils et fournit des résultats vérifiables pour les tâches complexes à étapes multiples.
AutomatisationNebius
Nebius est une plateforme cloud haute performance spécialement conçue pour les charges de travail exigeantes en IA et en Machine Learning. Elle offre un accès évolutif aux derniers GPU NVIDIA, des instances uniques aux clusters massifs, complété par une suite de services gérés et un AI Studio intégré pour rationaliser l'ensemble du cycle de vie du ML, de la formation à l'inférence.
Cloud GPUUltiHash
UltiHash est une plateforme de stockage d'objets haute performance, native de Kubernetes, spécialement conçue pour les charges de travail d'IA et de big data. Elle offre un accès aux données ultra-rapide, des économies de coûts significatives grâce à une déduplication avancée au niveau de l'octet, et un déploiement flexible dans des environnements cloud, sur site ou hybrides. Son API compatible S3 assure une intégration transparente avec les piles de données et les flux de travail d'IA existants.
Opérations de Machine Learning
DevBlogs
DevBlogs est une bibliothèque organisée qui indexe des études de cas d'ingénierie, des blogs techniques et des conférences de grandes équipes mondiales. Il organise le contenu par signification et par sujets techniques spécifiques, offrant une ressource précieuse aux développeurs et ingénieurs pour découvrir des informations et des meilleures pratiques.
InfrastructureTruefoundry
Truefoundry est une plateforme d'entreprise pour le déploiement, la gestion et la mise à l'échelle d'applications d'IA agentique. Elle fournit une passerelle IA unifiée pour orchestrer des flux de travail IA complexes, gérer les modèles et garantir la sécurité, la gouvernance et l'observabilité. Conçue pour les développeurs et les équipes MLOps, elle prend en charge les déploiements sur site, dans le cloud et hybrides, optimisant l'utilisation des GPU et accélérant la mise sur le marché.
Cloud computing
Baseten
Baseten est une plateforme d'inférence de qualité production pour déployer, mettre à l'échelle et gérer des modèles d'IA. Elle offre des runtimes haute performance, des flux de travail de développeur fluides et des options de déploiement flexibles (cloud, auto-hébergé, hybride). Idéal pour les équipes d'ingénierie et de ML qui construisent des applications d'IA critiques.
Déploiement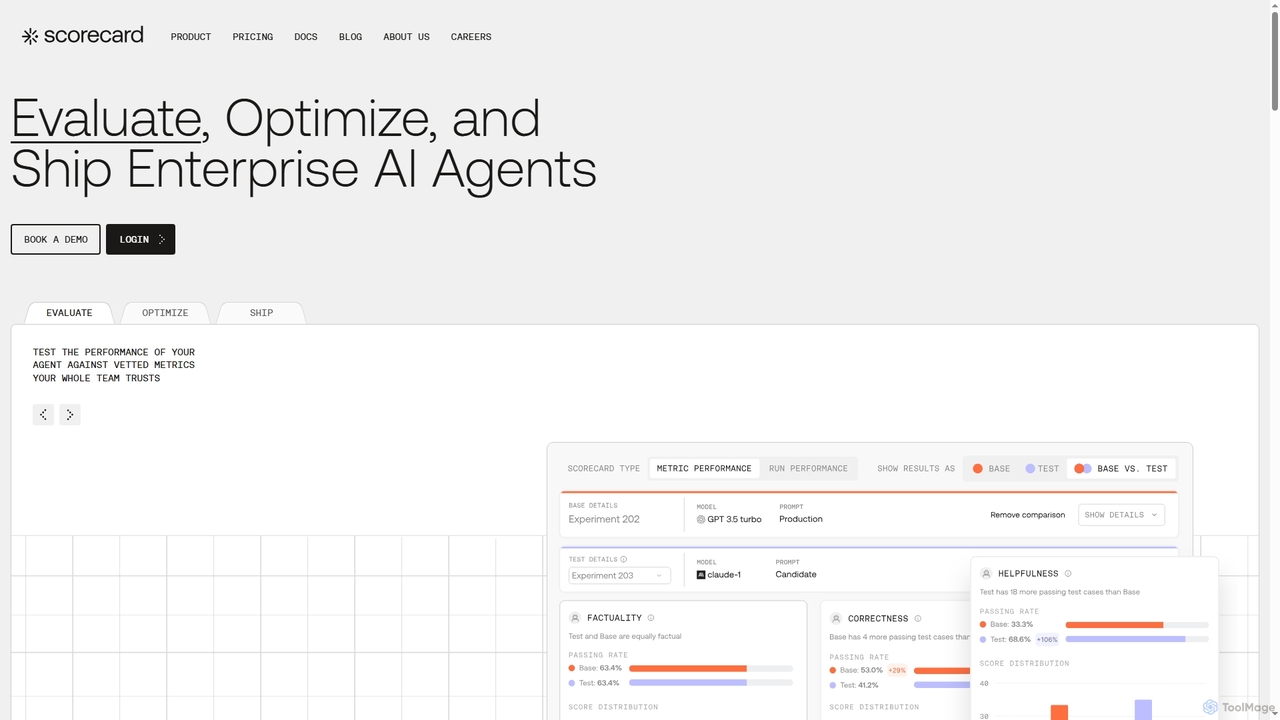
Scorecard
Scorecard est une plateforme de bout en bout pour évaluer, optimiser et déployer des agents IA d'entreprise. Elle aide les équipes à remplacer les tests subjectifs par des évaluations structurées, en fournissant des outils de surveillance continue, de gestion des prompts et de métriques de performance pour construire des applications IA fiables et dignes de confiance.
Évaluation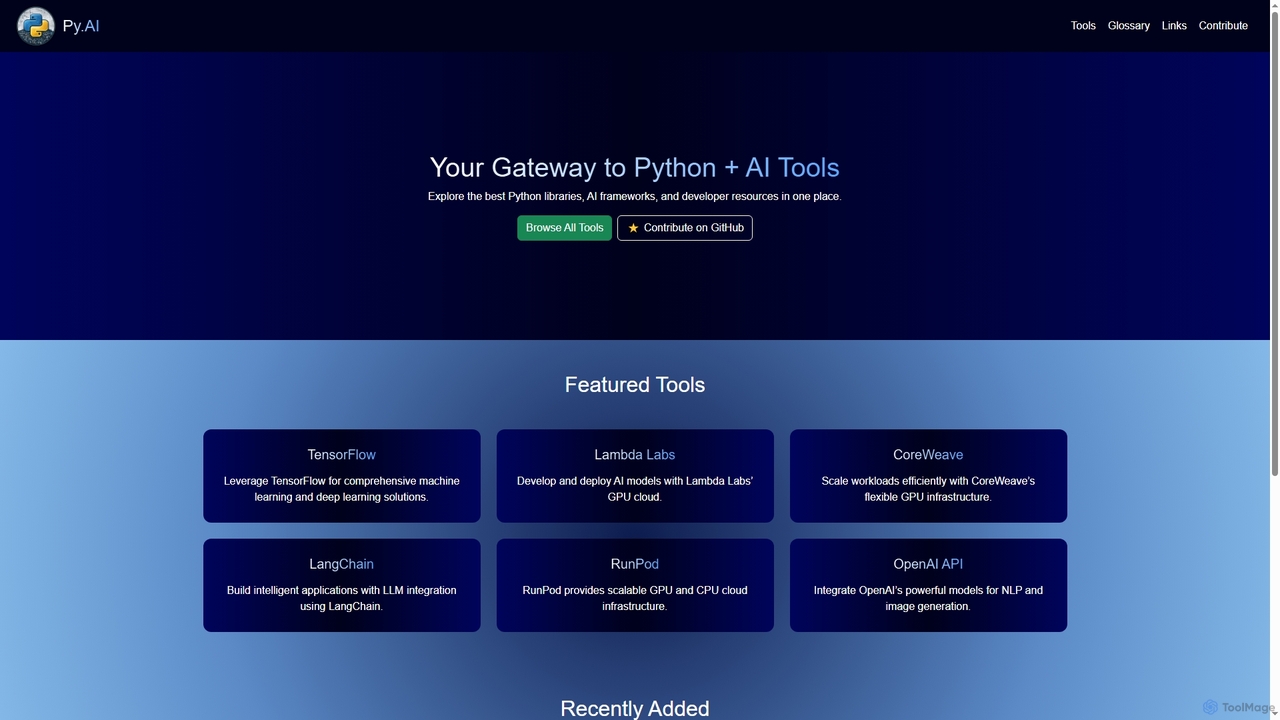
Py
Py est un répertoire en ligne organisé servant de passerelle complète vers les meilleures bibliothèques Python, frameworks d'IA et ressources pour développeurs. Il aide les utilisateurs à explorer, découvrir et trouver des outils pour améliorer leurs projets d'apprentissage automatique et d'IA.
Découverte d'outils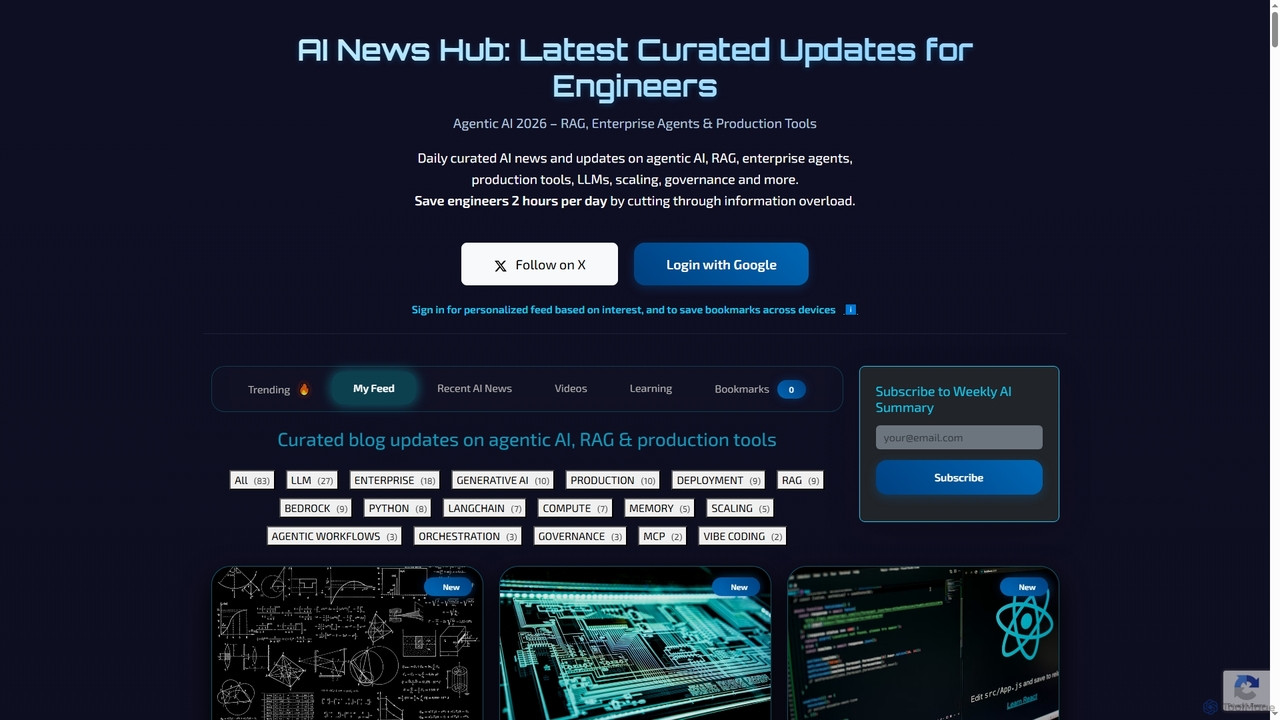
AI News Hub
AI News Hub est une plateforme complète fournissant des annonces d'IA en temps réel, des mises à jour de blogs curatées sur l'IA agentique, le RAG et les outils de production. Elle offre un flux personnalisé, des fonctionnalités de favoris et une riche collection de ressources d'apprentissage, y compris des feuilles de route, des cours et des vidéos, pour maintenir les développeurs et les passionnés informés et compétents dans le paysage de l'IA en évolution rapide.
Aggregation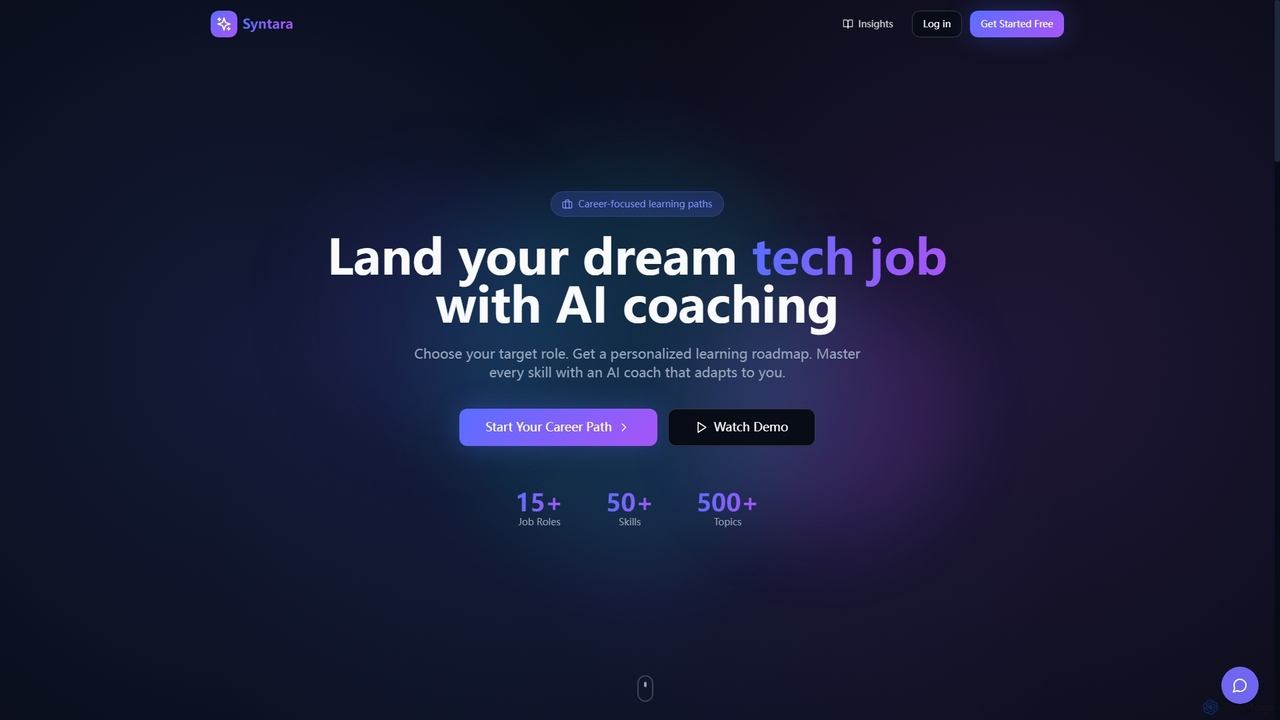
Syntara
Syntara est une plateforme d'apprentissage alimentée par l'IA conçue pour accélérer les carrières technologiques. Elle offre des parcours d'apprentissage personnalisés, un coaching adaptatif par IA et des chemins de compétences structurés pour aider les individus à maîtriser les compétences technologiques très demandées comme l'IA/ML, l'ingénierie des prompts et la science des données, et à décrocher l'emploi de leurs rêves.
Machine Learning Education
PostgresML
PostgresML est une puissante extension open-source qui intègre l'apprentissage automatique et l'IA directement dans votre base de données PostgreSQL. Elle permet l'inférence accélérée par GPU, la recherche vectorielle et des pipelines RAG complets à l'aide de simples commandes SQL, éliminant le mouvement des données et simplifiant la pile MLOps pour des applications IA performantes et évolutives.
MLOps
StackSpaces
StackSpaces est une plateforme de développement intégrée conçue pour aider les développeurs à créer, déployer et mettre à l'échelle des applications d'IA full-stack avec facilité. Elle fournit un environnement unifié avec des composants backend, frontend et d'infrastructure, rationalisant l'ensemble du cycle de vie du développement, de l'idée à la production.
Backend
Evidently AI
Evidently AI est une plateforme complète de test et d'évaluation pour les produits d'IA, spécialisée dans la surveillance des modèles LLM et ML. Elle aide les équipes à garantir la sécurité, la fiabilité et les performances de l'IA grâce à une évaluation automatisée, la génération de données synthétiques, des tests continus et des attaques adverses. Basée sur une puissante bibliothèque open source, elle est conçue pour les data scientists et les ingénieurs MLOps afin de détecter les problèmes tels que les hallucinations, la dérive des données et les fuites de PII avant qu'ils n'affectent les utilisateurs.
Apprentissage automatique
Raven Comments (0)
Sign in to comment.
ConnexionNo comments yet.