

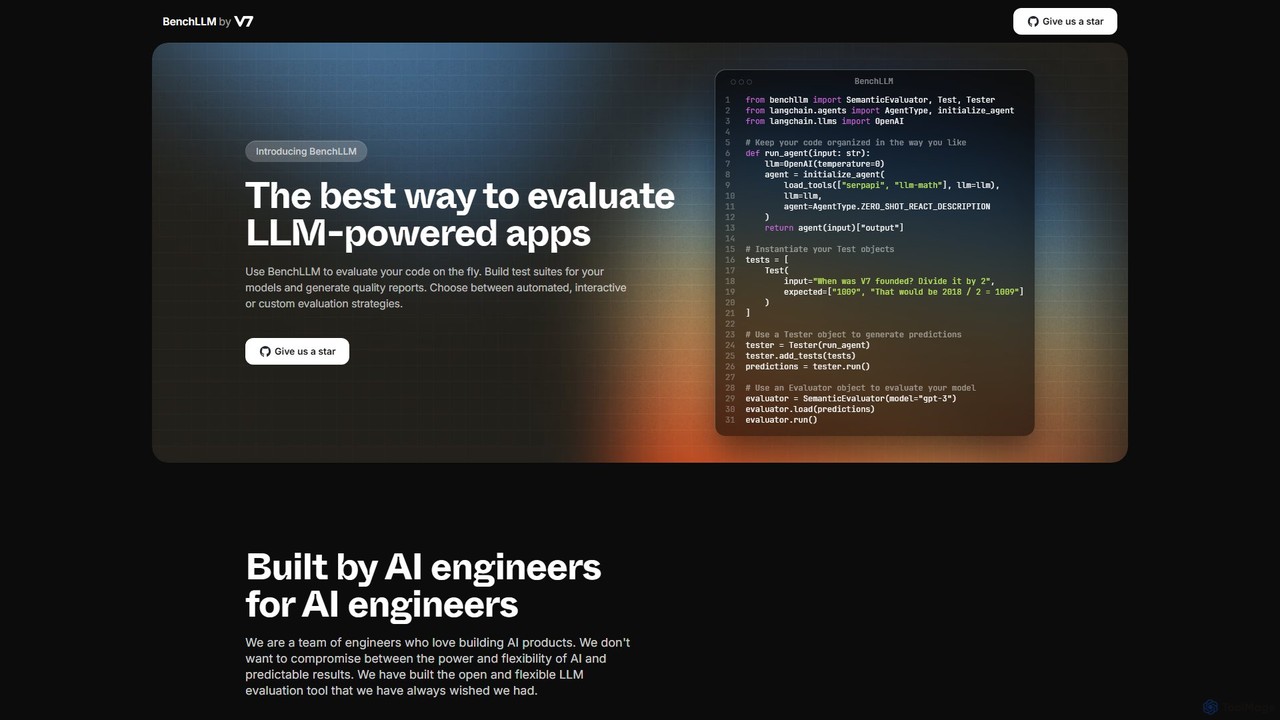
BenchLLM Overview
BenchLLMは、AIエンジニアによってAIエンジニアのために丹念に作られた、専門的なオープンソースの評価フレームワークです。大規模言語モデル(LLM)を搭載したアプリケーションにおける信頼性と予測可能性を確保するという重要な課題に直接取り組みます。AIモデルがより強力になり、製品に統合されるにつれて、体系的なテストの必要性は「あれば尚良い」ものから、開発ライフサイクルの不可欠な部分へと変化しました。BenchLLMは、LLMの確率的な性質と、決定論的で高品質なパフォーマンスへの要求との間のギャップを埋めるツールを提供します。
このフレームワークは、強力かつ柔軟に設計されており、開発者が包括的なテストスイートを作成、管理、実行できるようにします。これらのテストは、事実の正確性、ハルシネーションの検出から、特定の出力形式の遵守まで、モデルのパフォーマンスの様々な側面を評価できます。これらの評価を開発ワークフローに直接統合することで、チームは自信を持って構築し、リグレッションを早期に発見し、一貫して優れたユーザーエクスペリエンスを提供できます。
BenchLLMの使い方
BenchLLMの使用は直感的で、既存の開発ワークフローに適合するように設計されています。プロセスは通常、いくつかの主要なステップで構成されます:
- インストール: Pythonライブラリとして、BenchLLMはpipのようなパッケージマネージャを使用してプロジェクト環境に簡単にインストールできます。
- テストの定義: YAMLやJSONのようなシンプルで人間が読みやすい形式を使用して、直感的にテストケースを定義できます。各テストケースは、入力プロンプトと1つ以上の期待される出力で構成されます。これにより、テストをソースコードと一緒に保存できるため、バージョン管理と共同作業が容易になります。
- コードとの統合: BenchLLMは、LLMを呼び出す関数をラップするためのシンプルなAPIを提供します。OpenAIライブラリを直接使用している場合でも、LangchainエージェントやカスタムAPIを使用している場合でも、BenchLLMテスターに簡単に接続できます。
- テストの実行: テストは、強力なコマンドラインインターフェース(CLI)を使用するか、Python APIを介してプログラムで実行できます。CLIコマンド `bench run` は、定義されたテストスイートを実行し、モデルから予測を生成します。
- 評価とレポート: テストを実行した後、`Evaluator`(例:`SemanticEvaluator`)を使用して、モデルの実際の出力を期待される出力と比較します。その後、BenchLLMは、どのテストが合格し、どのテストが失敗したかを明確に示す洞察に満ちたレポートを生成し、デバッグと改善に必要なコンテキストを提供します。
BenchLLMの主な機能
- 柔軟なテスト定義: 管理しやすいYAMLまたはJSONファイルでテストを作成・整理し、明確でバージョン管理されたテストスイートを実現します。
- 強力なCLI: 堅牢なコマンドラインインターフェースにより、評価の実行、レポートの生成、CI/CDパイプラインへのテストのシームレスな統合が可能になり、完全な自動化を実現します。
- 多機能なAPI: 開発者フレンドリーなPython APIにより、アプリケーションコード内で直接、オンザフライのテストやカスタム評価ロジックを実装できます。
- 複数の評価戦略: 完全一致、正規表現、高度な意味的類似性チェックなど、様々な評価方法をサポートし、モデルの出力品質を正確に評価します。
- 幅広い互換性: OpenAIやLangchainなどの人気ライブラリを標準でサポートし、任何のカスタムLLM APIとも連携できるように拡張可能です。
- 包括的なレポート: 失敗、パフォーマンスメトリクス、リグレッションを強調表示する、明確で実用的な評価レポートを生成し、チームと簡単に共有できます。
- 本番環境の監視: このフレームワークは、本番環境でのモデルのパフォーマンスを監視し、パフォーマンスのドリフトを検出して継続的な信頼性を確保するために使用できます。
BenchLLMの使用例
BenchLLMは多用途であり、AI開発ライフサイクル全体の多くのシナリオで適用できます。主な使用例には、CI/CDでのリグレッションテスト(新しい変更がモデルのパフォーマンスを低下させていないことを自動的に検証)、ハルシネーションの検出(既知の答えがない質問(例:未来の出来事)を含むテストを作成し、モデルが適切に応答することを確認)、モデルのベンチマーキング(同じテストスイートを異なるLLM(例:GPT-4対Claude 3)やプロンプトのバリエーションに対して実行し、パフォーマンスを客観的に測定・比較)、そして品質保証(すべてのモデルバージョンがデプロイ前に満たすべき品質基準を設定)があります。
BenchLLMの利点
BenchLLMの主な利点は、開発者第一の考え方で構築されていることです。一部のクローズドボックスソリューションとは異なり、エンジニアに評価プロセスに対する完全な制御を与える、オープンで柔軟なツールです。オープンソースであるため、最大限の透明性とカスタマイズ性を提供します。これにより、LLM開発は試行錯誤から、より構造化され予測可能なエンジニアリング分野へと変わります。退屈でエラーが発生しやすい手動テスト作業を自動化することで、開発サイクルを大幅に効率化し、製品の品質を向上させ、開発者の生産性を高めます。
料金プラン
BenchLLMは、V7のチームによって構築・維持されている完全に無料のオープンソースツールです。誰でもGitHubリポジトリからダウンロード、使用、貢献することができます。全機能を使用するために有料プラン、サブスクリプション、隠れたコストは一切必要なく、個人開発者、スタートアップ、大企業にとってアクセスしやすい選択肢となっています。
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 317
- 2026-1: 1.2K
- 2026-2: 597
- 2026-3: 210
- 2026-4: 0
- 2026-5: 955
Geography
Top 5 countries / regions
- 🇮🇳インド100.0%
BenchLLM Alternatives
codegate
Codegateは、AIエージェントシステム向けのオープンソースのセキュリティゲートウェイおよびマルチプレキシングフレームワークです。Stacklokによって開発され、安全なワークスペースとポリシーベースのアクセス制御を提供し、開発者が複雑なマルチエージェントアプリケーションを安全かつ効率的に構築・管理できるようにします。
主体的なフレームワーク
CopilotKit
CopilotKitは、開発者がアプリ内AIコパイロットやエージェントアプリケーションを構築、デプロイ、カスタマイズするためのオープンソースのフルスタックフレームワークです。フロントエンドコンポーネント、バックエンドロジック、そしてあらゆるLLMやエージェントフレームワークとのシームレスな統合を提供し、強力なユーザー向けAIアシスタントの作成を可能にします。
フレームワークBenchLLM Categories
BenchLLM Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools

GPT Researcher
GPT Researcherは、迅速かつ詳細なリサーチのために設計されたオープンソースの自律型AIエージェントです。信頼できる情報源からの情報収集、調査結果の整理、引用付きの包括的なレポート作成まで、リサーチプロセス全体を自動化します。開発者、アナリスト、研究者に最適で、あらゆるLLMや検索エンジンと統合し、どんなトピックについても数分で正確かつ事実に基づいた結果を提供します。
API
codegate
Codegateは、AIエージェントシステム向けのオープンソースのセキュリティゲートウェイおよびマルチプレキシングフレームワークです。Stacklokによって開発され、安全なワークスペースとポリシーベースのアクセス制御を提供し、開発者が複雑なマルチエージェントアプリケーションを安全かつ効率的に構築・管理できるようにします。
主体的なフレームワーク
CopilotKit
CopilotKitは、開発者がアプリ内AIコパイロットやエージェントアプリケーションを構築、デプロイ、カスタマイズするためのオープンソースのフルスタックフレームワークです。フロントエンドコンポーネント、バックエンドロジック、そしてあらゆるLLMやエージェントフレームワークとのシームレスな統合を提供し、強力なユーザー向けAIアシスタントの作成を可能にします。
フレームワーク
Confident AI
Confident AIは、エンジニアリングチーム向けのLLM評価およびオブザーバビリティプラットフォームです。オープンソースのDeepEvalライブラリの作成者によって構築され、包括的なメトリクス、回帰テスト、詳細なトレースを通じてLLMアプリケーションのベンチマーク、保護、改善を支援し、一貫したAIパフォーマンスを保証します。
モデル管理
Blaxel
Blaxelは、AI開発者向けに設計されたサーバーレスコンピューティングプラットフォームであり、エージェント型AIアプリケーションを効率的に構築、デプロイ、スケーリングするためのインフラストラクチャとツールを提供します。サンドボックス化されたVM、統合LLMゲートウェイ、詳細な可観測性を特徴としています。
クラウドコンピューティング
Meticulous
Meticulousは、AIを活用してフロントエンドテストを革新するツールです。ユーザーの操作を記録することで、視覚的なエンドツーエンドテストを自動的に生成・維持し、手動でのテストスクリプト作成を不要にします。これにより、開発チームはリグレッションを検出し、エッジケースをカバーし、不安定でメンテナンスコストの高いテストの手間をかけずに、自信を持ってより迅速にコードをリリースできます。
コード品質
BenchLLM Comments (0)
Sign in to comment.
ログインNo comments yet.