
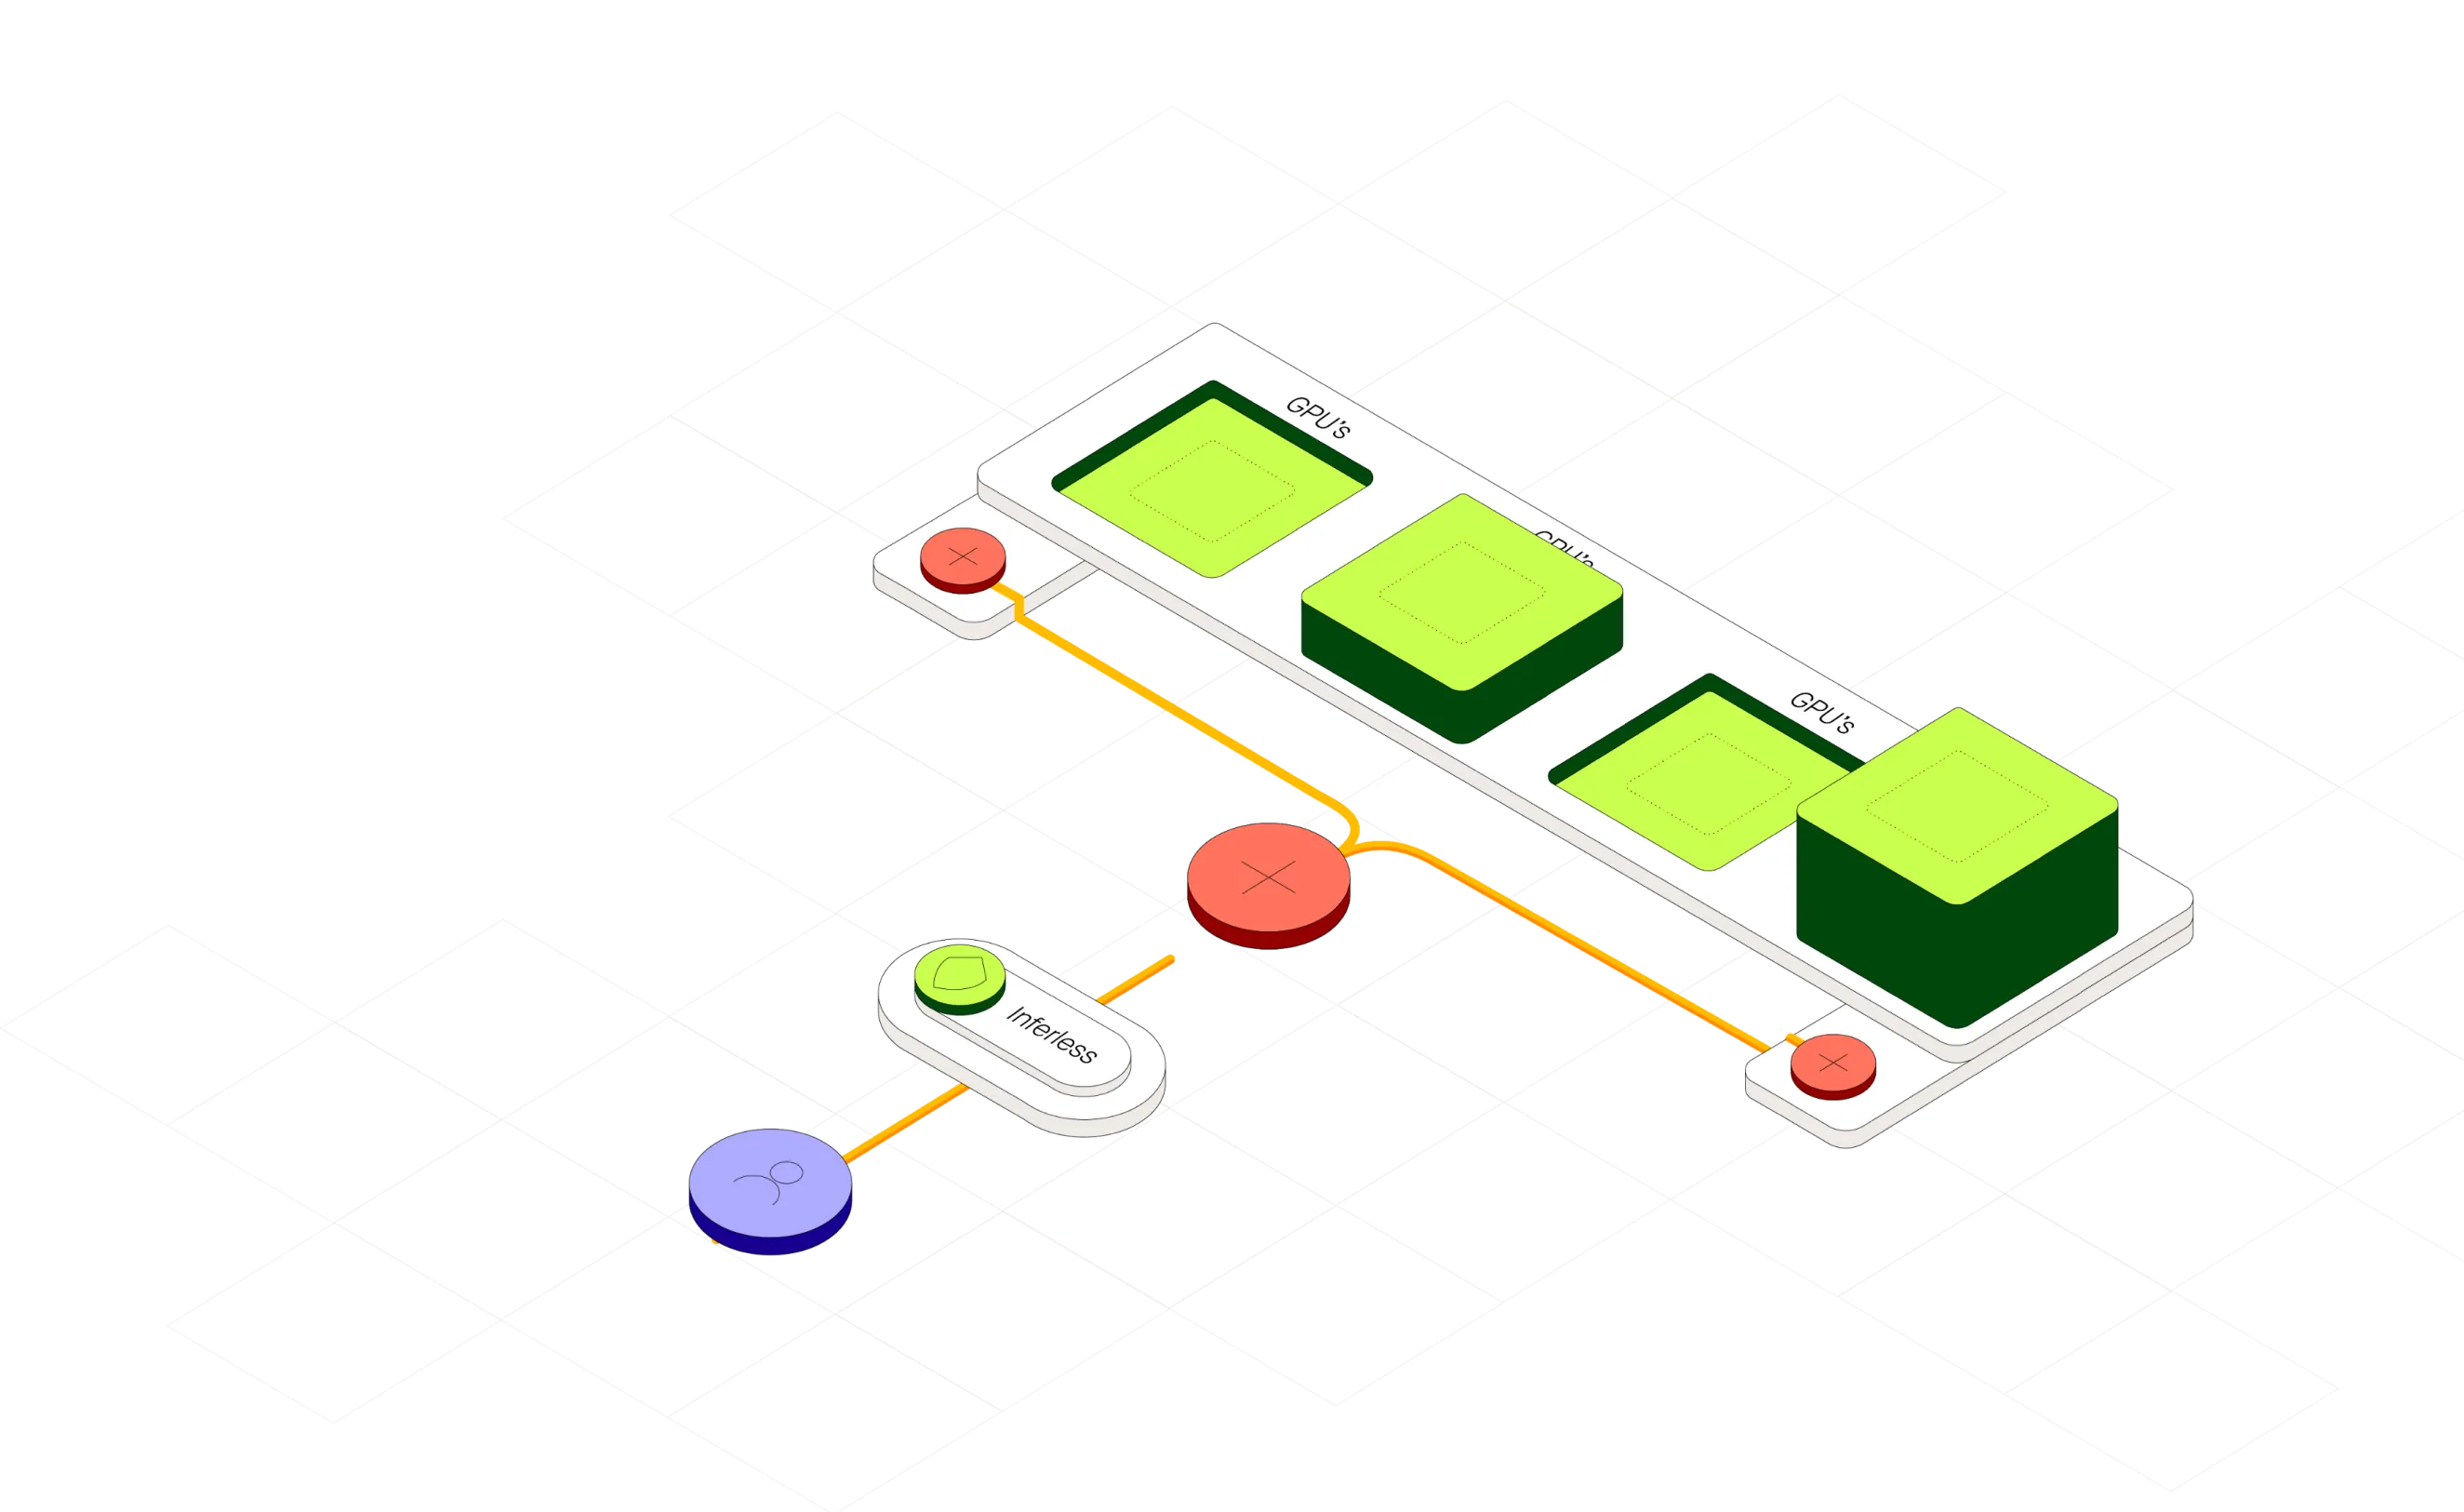

Inferless 概览
Inferless 是一个尖端的无服务器 GPU 平台,旨在简化生产工作负载的机器学习模型部署流程。它使开发人员和数据科学家能够在短短几分钟内从模型文件变为实时、可扩展的 API 端点,完全无需关心复杂的基础设施管理。通过支持从 Hugging Face、Git、Docker 或其自有 CLI 等来源直接部署,Inferless 提供了无与伦比的灵活性,并加速了产品化进程。
该平台凭借其强大的自动扩展能力,可按需从零扩展到数百个 GPU,专为处理不可预测的突发性流量模式而构建。这确保了高可用性和高性能,同时避免了闲置资源的成本。Inferless 非常注重企业级的可靠性和安全性,已通过 SOC-2 Type II 认证并定期进行漏洞扫描,是各种规模企业的可靠选择。
如何使用 Inferless
在 Inferless 上部署模型是一个为速度和效率而设计的简单过程:
- 注册并连接: 创建一个 Inferless 帐户并连接您的模型源。您可以直接集成您的 Hugging Face 帐户、Git 仓库或 Docker 镜像仓库。
- 导入您的模型: 在 Inferless 工作区中,选择“添加自定义模型”。选择您的提供商,输入模型名称,并指定其类型(例如 Transformer、Diffuser)和任务(例如文本生成、文本到图像)。
- 自定义配置: 根据您的需求定制部署。您可以修改推理代码(例如 `app.py`),定义自定义输入模式,并使用特定的软件依赖项和库来配置运行时环境。
- 配置硬件和扩展: 选择合适的 GPU 类型(例如 Nvidia T4、A10、A100)。设置最小和最大副本数以定义自动扩展行为。配置推理超时、容器并发和缩减周期等设置。
- 部署和监控: 点击“部署”以构建您的模型并启动端点。上线后,您可以使用详细的调用和构建日志来监控性能、调试问题并高效地优化您的模型。
Inferless 的核心功能
- 无服务器 GPU 基础设施: 无需基础设施设置或管理。平台自动处理资源配置、扩展和维护。
- 闪电般的冷启动: 优化的架构确保即使是大型模型也能实现亚秒级响应时间,消除了预热延迟。
- 动态自动扩展: 根据实时流量自动从零扩展到数百个 GPU,确保最佳性能和成本。
- 动态批处理: 通过自动将多个服务器端请求合并为单个批次,提高吞吐量和 GPU 利用率。
- 自定义运行时: 完全灵活地使用任何必要的软件和依赖项自定义容器环境。
- 自动化 CI/CD: 为模型启用自动重建功能,在源仓库发生更改时自动重新部署,从而简化开发生命周期。
- 持久化卷: 提供类似 NFS 的可写卷,支持并发连接,从而实现有状态应用程序和高效的数据共享。
- 企业级安全: 通过 SOC-2 Type II 认证,并定期进行渗透测试和漏洞扫描以确保数据安全。
Inferless 的使用案例
Inferless 适用于广泛的 AI 应用:
- 生成式 AI 应用: 以低延迟部署用于聊天机器人、内容创作和代码生成的大型语言模型 (LLM)。
- 实时 API: 为需要高每秒查询率 (QPS) 和即时响应的服务提供支持,例如欺诈检测或推荐引擎。
- 计算机视觉: 大规模提供用于图像识别、目标检测和图像生成的模型。
- 音频和语音处理: 托管文本转语音 (TTS)、语音转文本和其他基于音频的 AI 模型。
- 经济高效的原型设计和生产: 帮助初创公司和企业在有效扩展的同时,大幅降低其 GPU 云账单(最高可达 90%)。
Inferless 的优势特点
使用 Inferless 的主要优势包括通过其按使用量付费模式节省大量成本,通过消除 DevOps 开销提高开发人员生产力,以及以最小延迟实现卓越性能。其可靠处理突发性工作负载的能力使其成为生产环境的强大解决方案。该平台在自定义运行时和与 Hugging Face 等工具的直接集成方面的灵活性,使其成为任何机器学习团队的多功能且强大的选择。
定价和计划
Inferless 提供透明的按使用量付费定价模型,并提供 30 美元的免费额度供您开始使用。
- GPU 定价(按秒计费):
- Nvidia T4: 0.66美元/小时
- Nvidia A10: 1.22美元/小时
- Nvidia A100 (80GB): 5.36美元/小时
- 存储卷定价: 每月前 50GB 存储免费。额外存储费用为 0.3美元/GB/月。
- 初创公司计划: 专为每月至少 10,000 次推理请求设计,包括 5 个 GPU 并发、15 天日志保留和通过私人 Slack 渠道提供支持。
- 企业计划: 适用于每月至少 100,000 次推理请求,具有 50 个 GPU 并发、365 天日志保留和专属支持工程师。
流量分析
最新流量情况
状态
月度流量趋势
- 2025-9: 31.3K
- 2026-1: 23.7K
- 2026-2: 15.1K
- 2026-3: 20.2K
- 2026-4: 13.3K
- 2026-5: 8.4K
地理位置
Top 5 国家/地区
- 🇺🇸美国32.3%
- 🇻🇳越南24.5%
- 🇮🇳印度22.9%
- 🇧🇷巴西11.0%
- 🇮🇹意大利9.3%
热门关键词
Inferless 替代方案
Supervised.co
Supervised.co 是一个用于构建、训练和部署监督式机器学习模型的端到端平台。它通过集成数据标注、自动化模型训练和一键式API部署,简化了MLOps生命周期,使团队能够高效地创建高性能AI解决方案。
数据标注
ClearML GenAI App Engine
一个企业级平台,用于快速部署、管理和扩展生成式AI应用。它提供统一的基础设施控制平面,以简化LLM部署、监控性能并优化计算成本,从而安全高效地加速生成式AI的采用。
MLOps
Inferless 分类
Inferless 嵌入功能
复制这段嵌入代码,将徽章放到博客、文章或产品官网,并把读者直接引导到 ToolMage 详情页。

相关 AI 工具


Lightning AI
Lightning AI 是一个旨在规模化构建、训练和部署 AI 模型的云平台。它将流行的开源 PyTorch Lightning 框架与 Lightning AI Studio 相结合,后者是一个无需设置、基于浏览器的协作环境。您可以访问强大的 GPU,从笔记本电脑无缝扩展到云端,并加速您的整个 AI 开发工作流程。
平台即服务 (PaaS)
Fluidstack
Fluidstack 是一个领先的 AI 云平台,为训练和部署前沿 AI 模型提供高性能的专用 GPU 集群。它提供数千个 GPU 的快速部署、带 24/7 专家支持的全托管服务,以及零出口费用的透明定价,助力 AI 团队无缝扩展,摆脱基础设施的束缚。
企业解决方案
PostgresML
PostgresML 是一款功能强大的开源扩展,可将机器学习和人工智能直接集成到您的 PostgreSQL 数据库中。它支持使用简单的 SQL 命令进行 GPU 加速推理、向量搜索和完整的 RAG 管道,从而消除了数据迁移的需要,并为高性能、可扩展的 AI 应用简化了 MLOps 堆栈。
MLOps
Inferless 评论 (0)
登录后发表评论。
登录暂无评论。