
Runpod 概览
Runpod 是一个端到端的 AI 云平台,旨在消除构建、训练和部署 AI 模型的复杂性。它为开发者、研究人员和企业提供了一个精简、强大且经济高效的解决方案,以满足其所有 AI/ML 计算需求。通过在全球数据中心网络中提供对各种 GPU 的按需访问,Runpod 使用户能够从创意走向生产就绪的应用程序,而无需面对基础设施管理、扩展和高成本等典型难题。
该平台专为构建者而生,专注于速度、灵活性和效率。无论您是微调大型语言模型、为应用程序提供实时推理服务,还是运行计算密集型模拟,Runpod 都提供了大规模执行所需的所有工具和基础设施。其目标是成为下一代 AI 公司的计算支柱,让他们能够专注于创新而非基础设施。
如何使用 Runpod
使用 Runpod 的工作流程非常直接,专为快速开发和部署而设计:
- 选择服务: 在 GPU Cloud(用于交互式开发和长时间运行的任务)或 Serverless(用于可扩展的按需推理端点)之间进行选择。
- 选择模板: 从 PyTorch、TensorFlow、Stable Diffusion 和各种 LLM 等流行框架和应用的广泛预构建模板中进行选择,快速启动您的项目。
- 启动 Pod: 在一分钟内启动一个启用 GPU 的环境,称为“Pod”。您可以自定义 GPU 类型、vCPU、RAM 和存储以满足您的特定需求。
- 连接和构建: 通过 SSH 或 Jupyter Lab 访问您的 Pod,以安装依赖项、上传代码并开始训练或构建您的应用程序。
- 管理数据: 利用持久卷或与 S3 兼容的网络卷来存储您的数据集、模型和容器数据。一个关键优势是数据传输没有入口或出口费用。
- 部署和扩展: 对于生产工作负载,将您的模型部署为无服务器端点。Runpod 的自动扩展功能将根据实时需求自动管理 GPU 工作线程的数量(从 0 到数千个),确保您只为使用的计算付费。
Runpod 的核心功能
- 可扩展的 GPU 计算: 可访问从消费级 RTX 4090 到企业级 H100 和 B200 的各种 GPU,可在经济高效的社区云和高安全性的安全云中使用。
- 无服务器 GPU: 将模型部署为 API 端点,可从零自动扩展以处理任何工作负载,从而消除闲置成本。
- FlashBoot 技术: 通过低于 200 毫秒的冷启动时间实现闪电般的扩展,确保您的应用程序始终响应迅速。
- 持久性存储: 与 S3 兼容的存储,无入口/出口费用,让您可以无缝地运行从数据提取到部署的完整 AI 管道。
- 预构建模板: 丰富的模板库,可立即为训练、推理等设置环境,显著减少设置时间。
- 全球基础设施: 在全球 8 多个地区部署工作负载,以实现低延迟性能和全球可靠性。
- 内置编排与监控: 平台自动处理任务排队和分发,并提供实时日志、监控和指标,无需自定义框架。
Runpod 的使用案例
Runpod 用途广泛,支持多种应用:
- 推理服务: 以低延迟大规模部署和提供图像、文本和音频生成模型的推理服务。
- 模型微调: 在您的特定数据集上高效且经济地训练和微调自定义模型。
- AI 代理: 构建和托管智能、自主的基于代理的系统和复杂工作流。
- 计算密集型任务: 运行要求苛刻的工作负载,如 3D 渲染、科学模拟和大规模数据处理。
Runpod 的优势特点
与传统云提供商相比,Runpod 具有显著优势:
- 成本效益: 凭借按秒计费、有竞争力的 GPU 定价以及零数据出口费用,用户报告其基础设施账单节省高达 90%。
- 速度与敏捷性: 在几秒钟内从创意到执行。该平台的快速配置、极短的冷启动时间和自动扩展能力加速了开发生命周期。
- 简便性: 抽象化基础设施的复杂性,使团队能够专注于其核心产品和功能,而不是 DevOps。
- 灵活性: 高度可定制的环境,包括 GPU 型号、扩展行为、空闲时间限制和数据中心位置。
- 可靠性: 企业级服务,具有 99.9% 的正常运行时间、内置故障转移和强大的安全性(正在进行 SOC2、HIPAA、GDPR 认证)。
定价和计划
Runpod 的定价透明且旨在实现成本效益。
- GPU Cloud: 按小时计费,价格因 GPU 类型以及是在安全云还是更实惠的社区云中而异。例如,RTX 4090 的价格可低至 0.69 美元/小时,而高端 H100 SXM 约为 2.69 美元/小时。
- Serverless (推理): 按处理时间的秒数计费。定价按 GPU 性能分层,对“Flex”(预热)和“Active”工作线程有不同的费率。此模型对于可变流量非常高效。
- 存储: 持久性 Pod 存储定价为 0.10 美元/GB/月。与 S3 兼容的网络卷存储更便宜,1TB 以下为 0.07 美元/GB/月。没有入口或出口费用。
- 预留: 对于长期工作负载,用户可以通过与销售团队联系以折扣价预留容量。
流量分析
最新流量情况
状态
月度流量趋势
- 2025-9: 1.6M
- 2026-1: 1.9M
- 2026-2: 1.9M
- 2026-3: 2.4M
- 2026-4: 2.3M
- 2026-5: 2.3M
地理位置
Top 5 国家/地区
- 🇺🇸美国58.8%
- 🇮🇳印度13.6%
- 🇩🇪德国13.6%
- 🇧🇷巴西7.4%
- 🇳🇬尼日利亚6.6%
流量来源
| 来源类型 | 百分比 |
|---|---|
直接访问 | 78.8% |
外链引荐 | 20.0% |
邮件 | 1.2% |
热门关键词
| 关键词 | 每次点击费用 |
|---|---|
| run pod | $4.13 |
| runpod | $2.14 |
| runpod password | $0.00 |
| runpod pricing | $4.51 |
| runpod serverless | $15.48 |
Runpod 的相关 YouTube 视频




Runpod 替代方案
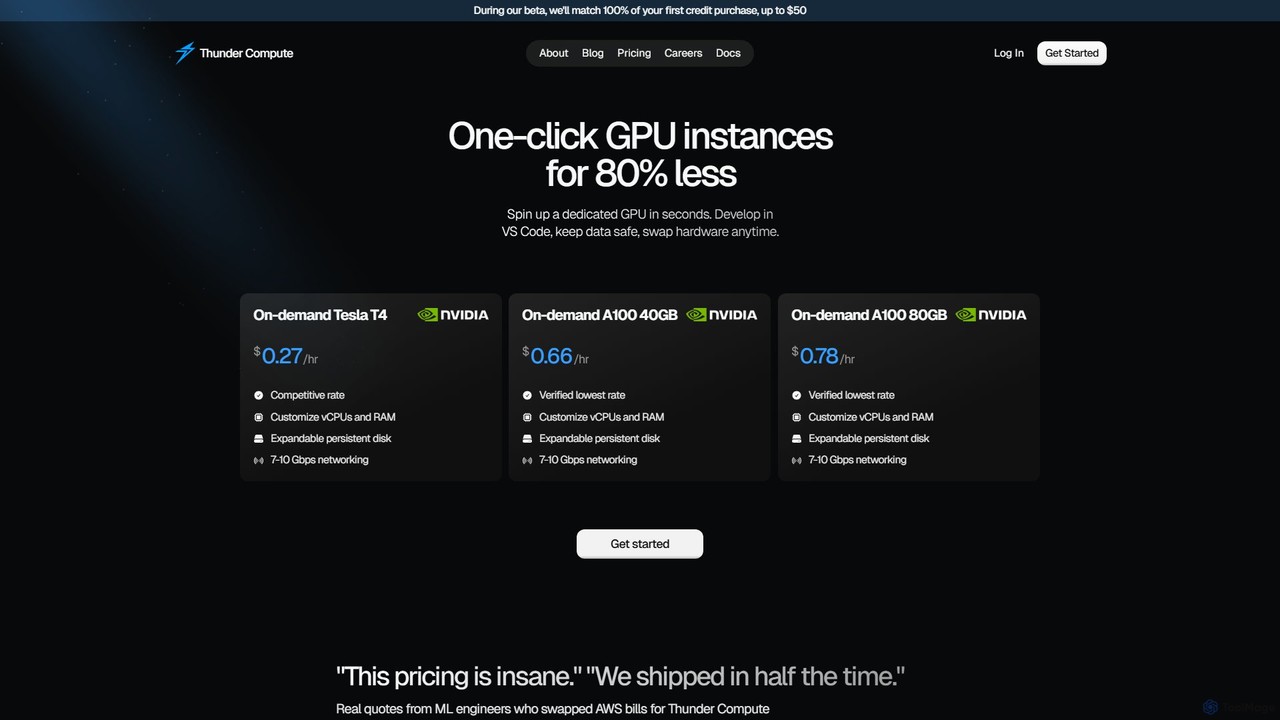
thundercompute
Thunder Compute 是一个超低成本的GPU云平台,专为AI和机器学习开发者设计。它提供NVIDIA A100和T4等按需GPU实例,价格比主流云服务商低80%。凭借一键设置、VS Code集成和无缝扩展等功能,它极大地简化了从原型设计到生产的开发工作流程,让开发者能专注于构建模型,而非管理基础设施。
机器学习
Fluidstack
Fluidstack 是一个领先的 AI 云平台,为训练和部署前沿 AI 模型提供高性能的专用 GPU 集群。它提供数千个 GPU 的快速部署、带 24/7 专家支持的全托管服务,以及零出口费用的透明定价,助力 AI 团队无缝扩展,摆脱基础设施的束缚。
企业解决方案
Runpod 分类
Runpod 嵌入功能
复制这段嵌入代码,将徽章放到博客、文章或产品官网,并把读者直接引导到 ToolMage 详情页。

相关 AI 工具

thundercompute
Thunder Compute 是一个超低成本的GPU云平台,专为AI和机器学习开发者设计。它提供NVIDIA A100和T4等按需GPU实例,价格比主流云服务商低80%。凭借一键设置、VS Code集成和无缝扩展等功能,它极大地简化了从原型设计到生产的开发工作流程,让开发者能专注于构建模型,而非管理基础设施。
机器学习
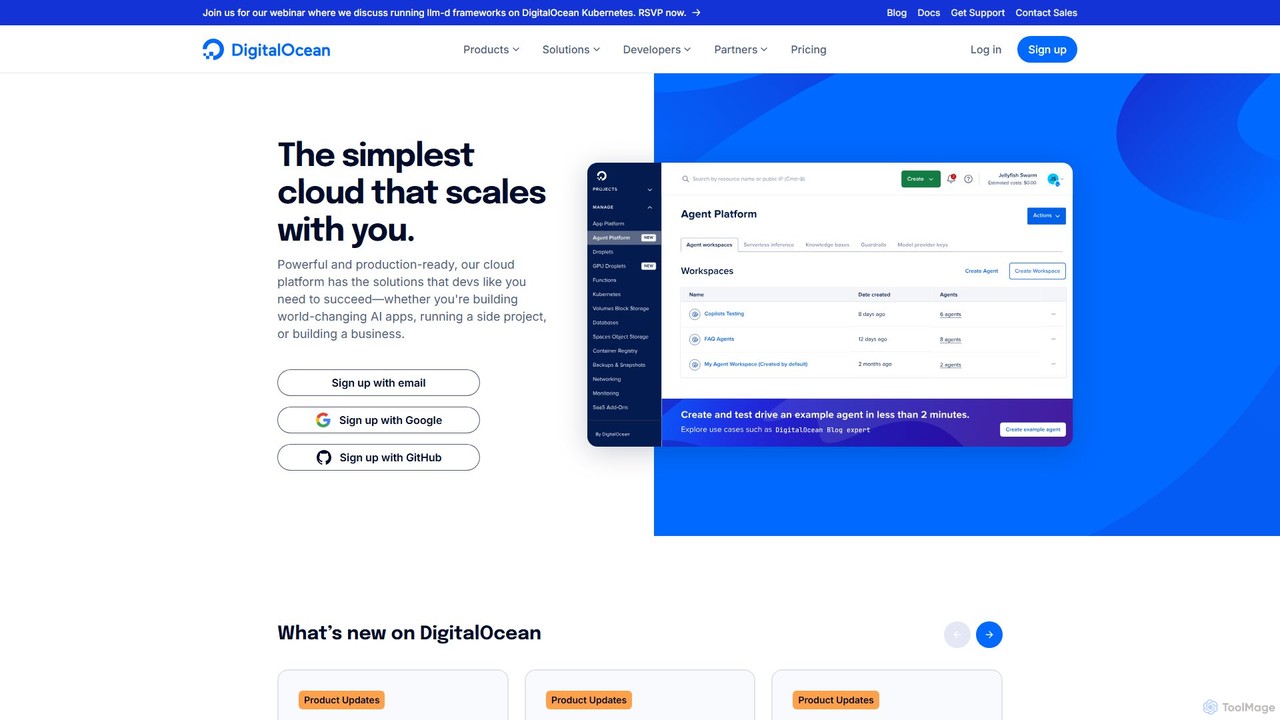
DigitalOcean
DigitalOcean 是一个专注于开发者的云基础设施平台,可简化应用程序的构建、部署和扩展。它提供一整套产品,包括虚拟机(Droplets)、托管 Kubernetes 和 GradientAI 平台,为创建和托管足以改变世界的人工智能应用(从个人项目到大型企业)提供强大的 GPU 资源和工具。
托管
Float16.cloud
Float16.cloud 是一个旨在加速人工智能开发的无服务器 GPU 平台。它提供对高性能 H100 GPU 的即时访问,具有按秒计费、零设置和无冷启动的特点。开发人员可以直接通过 Python 脚本部署开源大语言模型、训练模型和运行 AI 工作负载,而无需管理基础设施。
平台即服务 (PaaS)
Together AI
Together AI 是一个领先的开发者云平台,提供快速、经济高效的基础设施来运行、微调和训练开源生成式AI模型。它提供超过200种模型的广泛库、无服务器推理API、可定制的微调功能和专用GPU集群,为构建和扩展AI应用创建了端到端的解决方案。
GPU基础设施

Runpod 评论 (0)
登录后发表评论。
登录暂无评论。