

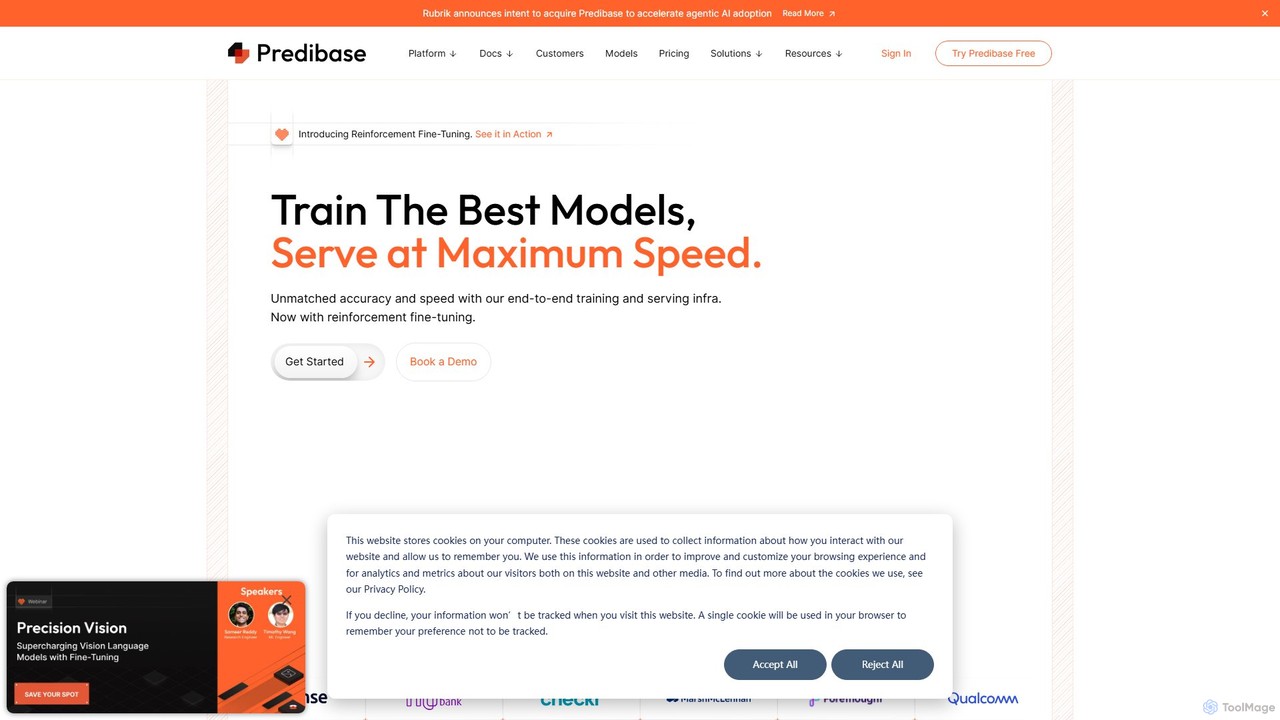
Predibase 概览
Predibase 将自己定位为微调和服务开源大型语言模型(LLM)的权威开发者平台。它提供了一个全面的端到端基础设施,使开发者和企业能够创建高度专业化、成本效益高且性能卓越的 AI 模型。通过利用最新的开源创新,Predibase 允许用户将 Llama 3、Mistral 和 Qwen 等模型应用于其特定用例,通常能在准确性上超越更大、更通用的模型(如 GPT-4),而所需的数据和成本却大大减少。
该平台建立在两大核心支柱之上:强大的训练和快速的服务。它引入了尖端技术,如强化学习微调(RFT),该技术允许仅用 10 个标记样本就能训练模型,并通过实时奖励函数持续改进。这极大地降低了创建自定义模型的门槛。在服务方面,Predibase 利用 LoRAX——一个开源引擎,支持在单个 GPU 上服务数百个微调后的模型适配器。这与 Turbo LoRA 等优化相结合,可将吞吐量提高多达 4 倍,并通过最大化 GPU 利用率显著节省成本。
如何使用 Predibase
Predibase 的工作流程设计得既简化又对开发者友好。以下是典型流程:
- 选择基础模型:从平台上广泛的流行开源 LLM 库中选择,如 Llama 3、Mistral 7B 或 CodeLlama,或上传您自己的自定义模型。
- 准备数据:上传您的数据集进行微调。Predibase 支持多种数据源,包括直接文件上传和为企业客户连接到 Snowflake、Databricks 和 S3 等数据仓库。该平台针对小数据场景进行了优化。
- 微调模型:配置并启动微调任务。您可以选择监督式微调(SFT)、持续预训练或先进的强化学习微调(RFT)等方法。平台会自动处理复杂的基础设施,包括量化和 LoRA 优化。例如,可以通过简单的 Python SDK 调用来启动微调任务:
adapter = pb.finetuning.jobs.create( config={ "base_model": "meta-llama/Llama-3-8b"}, dataset=my_dataset, repo="my_custom_adapter" ) - 部署和服务:微调完成后,生成的模型适配器可以立即部署到无服务器端点。Predibase 的基础设施负责自动扩展以应对流量高峰,并能在空闲时缩减至零以节省成本。
- 查询模型:通过简单的 API 调用与您部署的模型进行交互,指定您要使用的适配器。这允许在相同的基础设施上动态加载不同的微调模型。
client.generate( prompt="在此输入您的提示", adapter_id="my_custom_adapter/1" )
Predibase 的核心功能
- 强化学习微调(RFT):用最少的标记数据(少至 10 个样本)训练高精度模型,并使用实时奖励函数指导训练过程。
- LoRAX 多适配器服务:在单个 GPU 部署上服务数百个不同的微调 LoRA 适配器,从而大幅降低基础设施成本和复杂性。
- Turbo LoRA:一种优化技术,可在不牺牲准确性的前提下,为微调模型提供高达 4 倍的吞吐量。
- 无服务器和专用部署:可选择按使用付费、可扩展至零的无服务器端点,或预留专用的 A100/H100 GPU 以保证容量和企业级的可靠性。
- 灵活的部署选项:使用完全托管的 Predibase AI Cloud,或在您自己的虚拟私有云(VPC)中(AWS、Azure 或 GCP)部署,以实现最高的数据安全性和控制。
- 广泛的模型库:访问并微调各种最先进的开源模型,包括 Llama、Mistral、Gemma、Qwen、Phi 等。
- 企业级安全:该平台已通过 SOC 2 Type II 认证,并提供多区域高可用性、日志记录、指标监控和蓝绿部署等功能。
Predibase 的使用案例
Predibase 用途广泛,可应用于各种受益于专业 AI 模型的任务:
- 自动生成代码文档:微调 CodeLlama 等模型,自动为函数生成准确且上下文感知的文档字符串,为开发者节省大量时间。
- 客户支持自动化:构建专业的聊天机器人和响应系统,能够理解公司特定的术语,并根据内部知识库提供准确的答案。
- 数据提取和摘要:创建定制模型,用于从非结构化文档(如发票、法律合同)中提取特定信息,或高保真地摘要长篇文章。
- 内容生成:开发能够以特定品牌声音和风格生成营销文案、产品描述或其他内容的模型。
- 行业特定分析:像 Checkr 这样的公司使用 Predibase 构建更公平、更高效的招聘工具,而 Marsh McLennan 则用它来自动化复杂的风险分析工作流程。
Predibase 的优势特点
使用 Predibase 的主要优势源于其对效率、性能和可访问性的关注:
- 大幅降低成本:通过在共享 GPU 上高效服务多个模型,并使用更小、经过微调的开源模型,客户报告称与使用 GPT-4 等大型专有 API 相比,成本节省高达 5 倍。
- 卓越的速度:LoRAX 和 Turbo LoRA 的结合提供了极快的推理速度,使其适用于实时、低延迟的应用。
- 在专业任务上精度更高:由于在相关数据上进行了训练,微调模型在特定领域的任务上始终优于大型通用模型。
- 简化的 MLOps:Predibase 抽象了训练和部署 LLM 的复杂基础设施管理,使团队能够专注于构建应用程序,而不是管理 GPU。
- 数据隐私和控制:VPC 部署选项确保敏感数据永远不会离开客户的云环境,满足严格的安全和合规要求。
定价和计划
Predibase 提供分层定价结构,以满足从个人开发者到大型企业的不同需求。
- 免费计划:包含 25 美元的免费额度(30 天后过期),最多 1 个用户,可使用 A100 GPU 进行微调,一个私有无服务器部署,以及带速率限制的免费共享无服务器推理。非常适合实验。
- SaaS 企业计划:专为生产工作负载设计。它包含免费计划的所有内容,外加团队席位、批量折扣、保证计算实例以支持扩展、额外的数据连接器(Snowflake、Databricks 等)以及通过 Slack 提供的专属支持。定价为定制。
- VPC 企业计划:适用于需要最高安全性的组织。它允许将 Predibase 平台直接部署到客户自己的 AWS、Azure 或 GCP 环境中。该计划提供所有企业功能,同时确保数据保留在用户控制之下。定价为定制。
基于用量的成本:
- 推理:私有无服务器部署按秒计费,费率取决于硬件(例如 L4、A10G、A100、H100)。这允许扩展至零。
- 微调:按每百万 token 定价,成本因模型大小和微调方法(例如,LoRA SFT 比 RFT 便宜)而异。
流量分析
最新流量情况
状态
月度流量趋势
- 2025-9: 27.9K
- 2026-1: 18.7K
- 2026-2: 8.9K
- 2026-3: 4.8K
- 2026-4: 3.8K
- 2026-5: 3.5K
地理位置
Top 5 国家/地区
- 🇺🇸美国51.2%
- 🇮🇳印度33.6%
- 🇩🇪德国15.2%
热门关键词
| 关键词 | 每次点击费用 |
|---|---|
| grpo finetuning | $0.00 |
| grpo training | $0.00 |
| predibase | $3.86 |
| sftconfig | $0.00 |
| sft warmstart | $0.00 |
Predibase 替代方案
Predibase 分类
Predibase 嵌入功能
复制这段嵌入代码,将徽章放到博客、文章或产品官网,并把读者直接引导到 ToolMage 详情页。

相关 AI 工具

Fireworks AI
一个为开发者设计的高性能平台,用于构建、定制和扩展生成式AI应用。它提供业界领先的快速推理引擎、先进的微调功能以及对广泛开源模型的访问,从而实现实时、高性价比的AI解决方案。
模型部署
Mistral AI
Mistral AI 是一家领先的人工智能公司,提供开源和高性能的大语言模型(LLM)。它提供多功能 AI 助手 Le Chat 和强大的开发者平台 La Plateforme,专注于为个人和企业用户提供可配置、高效和注重隐私的解决方案。
企业解决方案
Together AI
Together AI 是一个领先的开发者云平台,提供快速、经济高效的基础设施来运行、微调和训练开源生成式AI模型。它提供超过200种模型的广泛库、无服务器推理API、可定制的微调功能和专用GPU集群,为构建和扩展AI应用创建了端到端的解决方案。
GPU基础设施
Fluidstack
Fluidstack 是一个领先的 AI 云平台,为训练和部署前沿 AI 模型提供高性能的专用 GPU 集群。它提供数千个 GPU 的快速部署、带 24/7 专家支持的全托管服务,以及零出口费用的透明定价,助力 AI 团队无缝扩展,摆脱基础设施的束缚。
企业解决方案
deepsense.ai
deepsense.ai 是一家顶尖的人工智能咨询和定制软件开发公司。他们专注于为企业创建量身定制的AI解决方案,利用在LLM、RAG、计算机视觉、MLOps和预测分析方面的专业知识。他们与企业和初创公司合作,将AI嵌入产品、优化运营,并通过先进的、可投入生产的AI系统获得竞争优势。
AI咨询
hyperficient
hyperficient 是一款面向开发者和机器学习工程师的开源人工智能工具,可自动搜索神经网络的最佳微调策略。它能显著降低计算成本、GPU 时间和人工投入,从而在有限的资源下实现最佳的模型性能。
库
Predibase 评论 (0)
登录后发表评论。
登录暂无评论。