

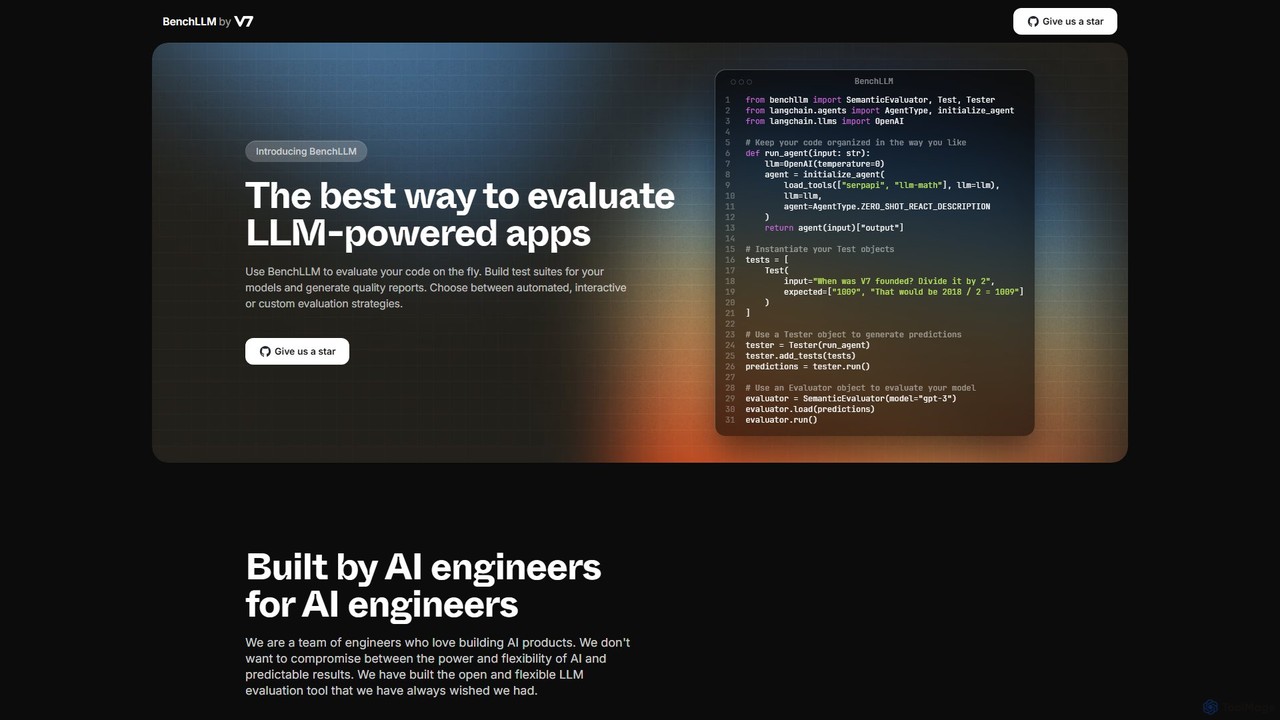
BenchLLM 概览
BenchLLM 是一個專業的開源評估框架,由AI工程師為AI工程師精心打造。它直接解決了確保大型語言模型(LLM)驅動的應用程式具有可靠性與可預測性這一關鍵挑戰。隨著AI模型變得越來越強大並整合至產品中,系統性測試已從「可有可無」轉變為開發生命週期中必不可少的一部分。BenchLLM 提供的工具旨在彌合LLM的機率性本質與對確定性、高品質效能需求之間的差距。
該框架的設計兼具強大功能與靈活性,允許開發人員建立、管理和執行全面的測試套件。這些測試可以評估模型效能的各個方面,從事實準確性、幻覺偵測到是否遵守特定的輸出格式。透過將這些評估直接整合到開發工作流程中,團隊可以充滿信心地進行建構,及早發現效能衰退,並持續提供卓越的使用者體驗。
如何使用BenchLLM
使用BenchLLM的過程非常直接,旨在融入現有的開發工作流程。該過程通常包括以下幾個關鍵步驟:
- 安裝: 作為一個Python函式庫,BenchLLM可以透過pip等套件管理器輕鬆安裝到您的專案環境中。
- 定義測試: 您可以使用YAML或JSON等簡單、人類可讀的格式直觀地定義測試案例。每個測試案例包含一個輸入提示和一個或多個預期輸出。這使得版本控制和協作變得容易,因為測試可以與您的原始碼一起儲存。
- 與您的程式碼整合: BenchLLM提供了一個簡單的API來包裝您呼叫LLM的函式。無論您是直接使用OpenAI函式庫、Langchain代理還是自訂API,都可以輕鬆地將其連接到BenchLLM測試器。
- 執行測試: 測試可以透過強大的命令列介面(CLI)或透過Python API以程式化方式執行。CLI指令 `bench run` 將執行您定義的測試套件並從您的模型產生預測。
- 評估與報告: 執行測試後,您可以使用 `Evaluator`(例如 `SemanticEvaluator`)將模型的實際輸出與預期輸出進行比較。然後,BenchLLM會產生富有洞察力的報告,清晰地顯示哪些測試通過、哪些失敗,為偵錯和改進提供必要的上下文。
BenchLLM的核心功能
- 靈活的測試定義: 在易於管理的YAML或JSON檔案中建立和組織測試,實現清晰、版本可控的測試套件。
- 強大的CLI: 強大的命令列介面允許您執行評估、產生報告,並無縫地將測試整合到CI/CD流程中以實現完全自動化。
- 多功能的API: 對開發者友善的Python API支援在您的應用程式碼中直接進行即時測試和自訂評估邏輯。
- 多種評估策略: 支援多種評估方法,包括精確匹配、正規表示式和先進的語義相似度檢查,以準確評估模型輸出品質。
- 廣泛的相容性: 提供對OpenAI和Langchain等流行函式庫的即裝即用支援,並且可擴展以與任何自訂LLM API配合使用。
- 全面的報告: 產生清晰且可操作的評估報告,突顯失敗、效能指標和衰退情況,可輕鬆與您的團隊共享。
- 生產環境監控: 該框架可用於監控生產環境中的模型效能,幫助偵測效能漂移並確保持續的可靠性。
BenchLLM的使用案例
BenchLLM功能多樣,可應用於AI開發生命週期的眾多場景。關鍵用例包括:CI/CD中的回歸測試,自動驗證新變更是否降低了模型的效能;幻覺偵測,透過建立包含未知答案(如未來事件)的問題的測試,以確保模型能做出適當的回應;模型基準測試,允許您針對不同的LLM(例如GPT-4與Claude 3)或不同的提示變體執行相同的測試套件,以客觀地衡量和比較它們的效能;以及品質保證,透過建立所有模型版本在部署前必須達到的品質基準。
BenchLLM的優勢特點
BenchLLM的主要優勢在於它以開發者為中心的設計理念。它是一個開放而靈活的工具,與某些封閉的解決方案不同,它讓工程師能夠完全控制評估過程。作為開源工具,它提供了最大的透明度和可自訂性。它將LLM開發從「試誤」轉變為一種更結構化、可預測的工程學科。透過自動化繁瑣且易錯的手動測試任務,它顯著簡化了開發週期,提高了產品品質,並提升了開發者的生產力。
定價和計劃
BenchLLM是一個完全免費的開源工具,由V7團隊建構和維護。任何人都可以透過其GitHub儲存庫下載、使用和貢獻。使用其全部功能無需付費計劃、訂閱或隱藏費用,這使其成為個人開發者、新創公司和大型企業的理想選擇。
流量分析
BenchLLM 替代方案
BenchLLM 分类
BenchLLM 嵌入功能
复制这段嵌入代码,将徽章放到博客、文章或产品官网,并把读者直接引导到 ToolMage 详情页。

相关 AI 工具

GPT Researcher
GPT Researcher 是一款開源的自主 AI 代理,專為快速、深入的研究而設計。它能自動化整個研究流程,從可靠來源收集資訊,到整理研究結果並產生附引用的綜合報告。它非常適合開發人員、分析師和研究人員,可與任何 LLM 和搜尋引擎整合,在幾分鐘內就任何主題提供準確、真實的結果。
API
CopilotKit
CopilotKit 是一個開源的全端框架,專為開發者設計,用於建構、部署和自訂應用程式內 AI 協駕和代理應用。它提供前端元件、後端邏輯,並能與任何 LLM 或代理框架無縫整合,從而創建功能強大的、面向使用者的 AI 助理。
框架
Confident AI
Confident AI 是一個面向工程團隊的 LLM 評估與可觀測性平台。由開源庫 DeepEval 的創建者打造,它透過全面的指標、回歸測試和詳細的追蹤來幫助基準測試、保障和改進 LLM 應用,確保 AI 效能的穩定性。
模型管理
Meticulous
Meticulous 是一款由人工智能驅動的工具,徹底改變了前端測試。它透過記錄使用者互動來自動生成和維護視覺化端對端測試,無需手動編寫測試腳本。這有助於開發團隊發現回歸問題、涵蓋邊緣案例,並充滿信心地更快地發布程式碼,同時擺脫了測試不穩定或維護成本高昂的煩惱。
程式碼品質
BenchLLM 评论 (0)
登录后发表评论。
登录暂无评论。