
Oncompute Overview
Oncompute, das unter dem Ocean Network betrieben wird, ist eine dezentrale Computing-Plattform, die ungenutzte oder unterausgelastete GPUs in eine verteilte, bedarfsgesteuerte Computeressource verwandelt. Es ermöglicht einen P2P-Marktplatz für GPU-Leistung, der sich hauptsächlich an KI-Entwicklung und Machine-Learning-Aufgaben richtet. Die Plattform betont einen nahtlosen „Code-zu-Knoten“-Workflow, der in beliebte Code-Editoren integriert ist und es Entwicklern ermöglicht, Jobs auszuführen, ohne ihre Entwicklungsumgebung zu verlassen. Durch die Nutzung eines dezentralen Modells zielt es darauf ab, wettbewerbsfähige Preise im Vergleich zu traditionellen Cloud-Anbietern zu bieten.
Wie man Oncompute verwendet
Die Nutzung ist darauf ausgelegt, in den Workflow des Entwicklers integriert zu werden. Benutzer können Computer-Jobs („Job ausführen“) direkt aus unterstützten integrierten Entwicklungsumgebungen (IDEs) wie VS Code, Cursor, Windsurf und Antigravity starten. Der Prozess umfasst die Auswahl von Computeressourcen (wie GPU-Typ) und das Starten des Jobs über die Ocean Orchestrator-Oberfläche. Die Ausgaben der Jobs werden lokal auf dem Rechner des Benutzers gespeichert.
Kernfunktionen von Oncompute
- Dezentrales P2P-Computing-Netzwerk: Verbindet Auftraggeber von Computing-Jobs mit GPU-Ressourcenanbietern auf Peer-to-Peer-Basis.
- Nutzungsbasierte Abrechnung: Benutzer zahlen nur für die tatsächliche Laufzeit ihrer Computing-Jobs.
- Editor-nativer Workflow: Tiefe Integration in IDEs (VS Code, Cursor, Windsurf, Antigravity) für eine nahtlose „Code-zu-Knoten“-Erfahrung.
- Treuhandgeschützte Zahlungen: Nutzt ein Treuhandsystem, um Transaktionen zwischen Auftraggebern und Computeranbietern zu sichern.
- Lokale Ausgabespeicherung: Ergebnisse von Computing-Jobs werden direkt auf dem lokalen Rechner des Benutzers gespeichert.
- Wettbewerbsfähige GPU-Preise: Ziel ist es, im Vergleich zu zentralisierten Cloud-Anbietern kostengünstigeren GPU-Zugang zu bieten, wie Preisvergleiche zeigen (z. B. H200 GPU zu $2,16/Std.).
Anwendungsfälle für Oncompute
Oncompute eignet sich für die Ausführung containerisierter KI- und Machine-Learning-Workloads, die erhebliche GPU-Rechenleistung erfordern. Dazu gehören Modelltraining, Inferenz, Batch-Verarbeitung und andere parallele Computing-Aufgaben, die in der Data Science und KI-Forschung üblich sind. Seine dezentrale Natur und sekundengenaue Abrechnung machen es ideal für experimentelle, sporadische oder kostensensible Projekte.
Vorteile von Oncompute
Der Hauptvorteil ist die Kosteneffizienz durch wettbewerbsfähige, dezentrale Preisgestaltung und ein sekundengenaues Abrechnungsmodell. Die tiefe IDE-Integration verringert die Reibung im Workflow der Entwickler erheblich. Das Treuhandsystem und die lokale Datenausgabe erhöhen Sicherheit und Benutzerkontrolle. Darüber hinaus bietet es einen Monetarisierungsweg für Besitzer ungenutzter GPUs.
Preise und Pläne
Oncompute arbeitet mit einem nutzungsbasierten Bezahlmodell und berechnet nur die Laufzeit der Computing-Jobs. Ein spezifisches Preisbeispiel ist die H200 GPU mit $2,16 pro Stunde, die im Vergleich zu AWS ($4,33/Std.) und Google Cloud ($3,72/Std.) günstiger ist. Die Plattform bietet neuen Benutzern $100 an Grant Tokens, um Hochleistungs-GPU-Workloads zum Testen freizuschalten.
Oncompute FAQ
Oncompute Alternatives
Replicate
Replicate ist eine Cloud-Plattform für Entwickler, um KI-Modelle über eine einfache API auszuführen, zu optimieren und bereitzustellen. Sie eliminiert die Notwendigkeit, komplexe Infrastrukturen zu verwalten, und bietet Zugriff auf Tausende von Modellen mit Pay-per-Use-Preisen und automatischer Skalierung.
Maschinelles Lernen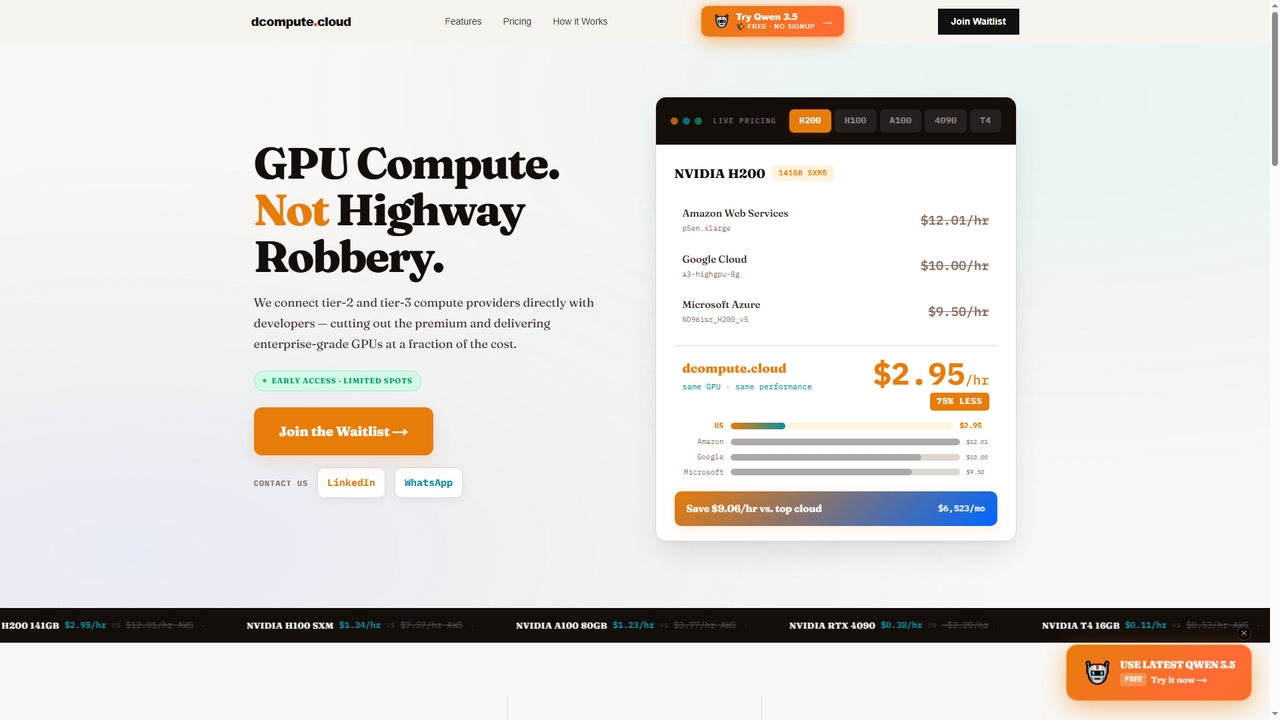
Dcompute
Dcompute ist ein dezentraler GPU-Computing-Marktplatz, der Entwickler direkt mit Tier-2- und Tier-3-Rechenzentrumsanbietern verbindet. Es bietet Enterprise-Grade-NVIDIA-GPUs (H200, H100, A100, RTX 4090, T4) zu einem Bruchteil der Kosten großer Cloud-Anbieter und verspricht Einsparungen von bis zu 90 %. Die Plattform bietet sofortige Bereitstellung, eine einheitliche API/Oberfläche, vollständige Orchestrierung und reine nutzungsabhängige Abrechnung pro Sekunde ohne Mindestgebühren.
GPU
Baseten
Baseten ist eine produktionsreife Inferenzplattform für die Bereitstellung, Skalierung und Verwaltung von KI-Modellen. Sie bietet hochleistungsfähige Laufzeitumgebungen, nahtlose Entwickler-Workflows und flexible Bereitstellungsoptionen (Cloud, Self-Hosted, Hybrid). Ideal für Ingenieur- und ML-Teams, die geschäftskritische KI-Anwendungen erstellen.
Bereitstellung
Zilliz
Zilliz ist eine Vektordatenbank für Unternehmen, die für skalierbare KI-Anwendungen entwickelt wurde. Angetrieben durch das beliebte Open-Source-Projekt Milvus, bietet es einen hochleistungsfähigen, kostengünstigen und vollständig verwalteten Dienst (Zilliz Cloud) zum Speichern, Indizieren und Durchsuchen von Milliarden von Vektor-Embeddings. Es ist darauf ausgelegt, Anwendungen wie RAG, Empfehlungssysteme und multimodale Suche zu unterstützen, mit nahtlosen Integrationen in wichtige KI-Frameworks und Cloud-Plattformen.
Maschinelles Lernen
Weaviate
Weaviate ist eine Open-Source, KI-native Vektordatenbank, die für Entwickler konzipiert wurde. Sie ermöglicht skalierbare, latenzarme Vektor-, Schlüsselwort- und Hybridsuchen. Ideal für die Erstellung von KI-Anwendungen wie semantischer Suche, Empfehlungssystemen und Retrieval-Augmented Generation (RAG)-Systemen, integriert sie sich nahtlos in gängige Machine-Learning-Modelle, um Daten basierend auf semantischer Bedeutung zu speichern und abzufragen.
VektordatenbankOncompute Categories
Oncompute Jobs
Oncompute Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Replicate
Replicate ist eine Cloud-Plattform für Entwickler, um KI-Modelle über eine einfache API auszuführen, zu optimieren und bereitzustellen. Sie eliminiert die Notwendigkeit, komplexe Infrastrukturen zu verwalten, und bietet Zugriff auf Tausende von Modellen mit Pay-per-Use-Preisen und automatischer Skalierung.
Maschinelles LernenDcompute
Dcompute ist ein dezentraler GPU-Computing-Marktplatz, der Entwickler direkt mit Tier-2- und Tier-3-Rechenzentrumsanbietern verbindet. Es bietet Enterprise-Grade-NVIDIA-GPUs (H200, H100, A100, RTX 4090, T4) zu einem Bruchteil der Kosten großer Cloud-Anbieter und verspricht Einsparungen von bis zu 90 %. Die Plattform bietet sofortige Bereitstellung, eine einheitliche API/Oberfläche, vollständige Orchestrierung und reine nutzungsabhängige Abrechnung pro Sekunde ohne Mindestgebühren.
GPUBaseten
Baseten ist eine produktionsreife Inferenzplattform für die Bereitstellung, Skalierung und Verwaltung von KI-Modellen. Sie bietet hochleistungsfähige Laufzeitumgebungen, nahtlose Entwickler-Workflows und flexible Bereitstellungsoptionen (Cloud, Self-Hosted, Hybrid). Ideal für Ingenieur- und ML-Teams, die geschäftskritische KI-Anwendungen erstellen.
Bereitstellung
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
AutomatisierungZilliz
Zilliz ist eine Vektordatenbank für Unternehmen, die für skalierbare KI-Anwendungen entwickelt wurde. Angetrieben durch das beliebte Open-Source-Projekt Milvus, bietet es einen hochleistungsfähigen, kostengünstigen und vollständig verwalteten Dienst (Zilliz Cloud) zum Speichern, Indizieren und Durchsuchen von Milliarden von Vektor-Embeddings. Es ist darauf ausgelegt, Anwendungen wie RAG, Empfehlungssysteme und multimodale Suche zu unterstützen, mit nahtlosen Integrationen in wichtige KI-Frameworks und Cloud-Plattformen.
Maschinelles LernenWeaviate
Weaviate ist eine Open-Source, KI-native Vektordatenbank, die für Entwickler konzipiert wurde. Sie ermöglicht skalierbare, latenzarme Vektor-, Schlüsselwort- und Hybridsuchen. Ideal für die Erstellung von KI-Anwendungen wie semantischer Suche, Empfehlungssystemen und Retrieval-Augmented Generation (RAG)-Systemen, integriert sie sich nahtlos in gängige Machine-Learning-Modelle, um Daten basierend auf semantischer Bedeutung zu speichern und abzufragen.
Vektordatenbank
Nebius
Nebius ist eine hochleistungsfähige Cloud-Plattform, die speziell für anspruchsvolle KI- und Machine-Learning-Workloads entwickelt wurde. Sie bietet skalierbaren Zugriff auf die neuesten NVIDIA-GPUs, von einzelnen Instanzen bis hin zu massiven Clustern, ergänzt durch eine Suite von Managed Services und ein integriertes AI Studio, um den gesamten ML-Lebenszyklus vom Training bis zur Inferenz zu optimieren.
GPU-Cloud
UltiHash
UltiHash ist eine hochleistungsfähige, Kubernetes-native Objektspeicherplattform, die speziell für KI- und Big-Data-Workloads entwickelt wurde. Sie bietet blitzschnellen Datenzugriff, erhebliche Kosteneinsparungen durch fortschrittliche Deduplizierung auf Byte-Ebene und flexible Bereitstellung in Cloud-, On-Premises- oder Hybrid-Umgebungen. Die S3-kompatible API gewährleistet eine nahtlose Integration in bestehende Daten-Stacks und KI-Workflows.
Machine Learning Operationen
NeocloudX
NeocloudX ist ein innovativer Marktplatz, der GPU-Rechenkapazität als Ware behandelt und es Benutzern ermöglicht, Hochleistungs-Computing-Ressourcen wie NVIDIA H100 SXM GPUs zu echten Marktpreisen zu kaufen, zu verkaufen und zu handeln. Es bietet sofortigen Zugriff auf Bare-Metal-Leistung über eine browserbasierte Konsole und ermöglicht erhebliche Kosteneinsparungen im Vergleich zu traditionellen Cloud-Anbietern.
Maschinelles Lerninfrastruktur
HackTheNews
HackTheNews ist eine KI-gestützte Nachrichtenaggregationsplattform für Technologiebegeisterte und Fachleute. Sie kuratiert eine breite Palette an Geschichten, Diskussionen und Projekten aus den Bereichen Technologie, Software und KI und bietet eine einzigartige „KI-Zusammenfassungen“-Funktion, um Schlüsselinformationen schnell zu erfassen. Benutzer können Trendthemen erkunden, an Diskussionen teilnehmen und neue Innovationen in der Tech-Welt entdecken.
3D
Ollama
Ollama ist ein leistungsstarkes Open-Source-Framework zum lokalen Ausführen von großen Sprachmodellen (LLMs) wie Llama 3, Mistral und Gemma auf Ihrer eigenen Hardware. Verfügbar für macOS, Windows und Linux, vereinfacht es die Einrichtung und Verwaltung von Open-Source-Modellen und ermöglicht eine private, offline-fähige und kostengünstige KI-Entwicklung und -Nutzung.
Maschinelles Lernen
SiliconFlow
SiliconFlow ist eine einheitliche KI-Infrastrukturplattform, die für die hochleistungsfähige Inferenz von Großen Sprachmodellen (LLMs) und multimodalen Modellen entwickelt wurde. Sie bietet Entwicklern und Unternehmen skalierbare, kostengünstige und flexible Bereitstellungsoptionen, einschließlich serverloser APIs, reservierter GPUs und Feinabstimmungsfunktionen, die alle über eine einzige, OpenAI-kompatible API zugänglich sind.
KI und Maschinelles Lernen
Label Your Data
Ein professioneller Datenannotationsdienst und eine Plattform, die hochwertige, genaue beschriftete Datensätze für maschinelles Lernen bereitstellt. Es unterstützt verschiedene Datentypen wie Bilder, Videos, Text und Audio und bietet flexible Preise, eine Self-Service-Plattform und vollständig verwaltete Dienste zur Skalierung von KI-Projekten jeder Größe.
Datenmanagement
Prodigy
Prodigy ist ein skriptfähiges Annotationstool für KI, maschinelles Lernen und NLP, das für Entwickler konzipiert wurde. Es ermöglicht die schnelle Erstellung hochwertiger Trainings- und Evaluierungsdaten durch modellgestützte, Human-in-the-Loop-Workflows. Es läuft auf Ihrer eigenen Infrastruktur und gewährleistet vollständige Datenprivatsphäre und Kontrolle.
Annotation
Vespa.ai
Vespa.ai ist eine hochleistungsfähige KI-Suchplattform zur Erstellung von Großanwendungen. Sie vereint Vektorsuche, Textsuche und maschinelles Lernranking, um fortschrittliche Anwendungsfälle wie Retrieval-Augmented Generation (RAG), Empfehlungssysteme und intelligente Suche zu ermöglichen. Entwickelt für Echtzeit-Inferenz und Skalierbarkeit, wird sie von führenden Unternehmen wie Spotify und Perplexity für die Verarbeitung riesiger Datenmengen mit geringer Latenz geschätzt.
Suche
Oncompute Comments (0)
Sign in to comment.
AnmeldenNo comments yet.