
DataChain Overview
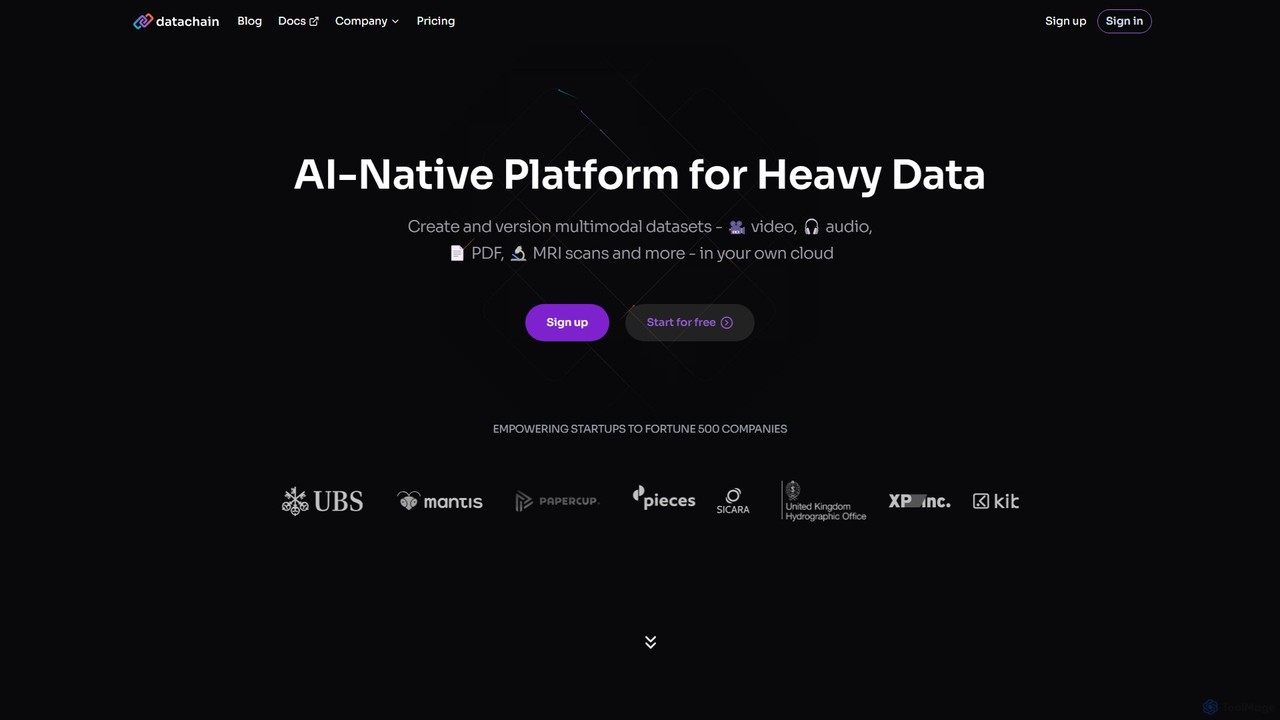
DataChainは、次世代AIの燃料となるリッチでマルチモーダルな非構造化データ「ヘビーデータ(Heavy Data)」の課題に取り組むために設計された、先進的なオープンソースプラットフォームです。人気のDVC(Data Version Control)を開発したチームによって作られたDataChainは、通常S3、GCS、Azureなどのオブジェクトストアに存在するビデオ、画像、音声ファイル、PDFなどの巨大なデータセットをキュレーション、エンリッチ、バージョン管理するための包括的なソリューションを提供します。
このプラットフォームは開発者第一の哲学で構築されており、チームが生の非構造化ファイルをAI対応の知識に変換することを可能にします。構造、埋め込み、重要な洞察の抽出を可能にし、これらは高度なAIエージェント、コパイロット、適応型ワークフローを動かすために不可欠です。ヘビーデータを競争上の優位性に変えることで、DataChainはチームが常にデータを再処理することなく、効率的で強力なデータパイプラインを構築するのを支援します。
DataChainの使い方
DataChainは、開発者の既存の環境にシームレスに統合される、コード中心の合理化されたワークフローを提供します。
- ローカルでの開発:まず、ローカルの統合開発環境(IDE)で直接、シンプルなPythonコードを使用してデータ処理パイプラインを定義します。この直感的なアプローチにより、複雑なSQLクエリや専門言語は不要になります。
- データソースへの接続:S3、GCS、Azureなどのオブジェクトストレージに保存されている非構造化データに接続します。DataChainはゼロコピーアーキテクチャで動作し、大きなファイルを複製することなくバージョンと参照を追跡するため、ストレージコストと時間を大幅に節約できます。
- 処理とエンリッチ:大規模言語モデル(LLM)やカスタム機械学習(ML)モデルをデータに適用して、洞察を抽出し、埋め込みを生成し、情報を構造化します。これには、音声の文字起こし、ビデオでの物体検出の実行、PDFからのテキスト解析などのタスクが含まれます。
- バージョン管理と追跡:DataChainは、すべてのコードとデータの依存関係を含む完全なデータリネージを追跡する中央集権的なデータセットレジストリを自動的に作成します。これにより、すべてのデータセットがバージョン管理され、監査可能で、完全に再現可能であることが保証されます。
- クラウドへのスケールアップ:パイプラインをローカルでテストした後、手戻りなしでクラウドにデプロイし、数百のGPUにスケールアップできます。プラットフォームは分散処理と自動スケーリングを処理し、数百万、さらには数十億のファイルを効率的に処理します。
- アクセスとクエリ:バージョン管理された構造化データセットは、Web UI、チャットインターフェース、IDEを介して、またはプラットフォームのAPIを介してAIエージェントが直接アクセスしてクエリできます。
DataChainの主な機能
- 中央集権的なデータセットレジストリ:完全なリネージ、メタデータ、バージョン管理を備えた、すべてのデータセットの単一の信頼できる情報源を提供します。
- SQLスケールでのPythonのシンプルさ:すべてのデータ操作に単一で直感的なPythonインターフェースを使用し、開発者にとって使いやすく、IDEやエージェントとの互換性も高めます。
- ローカルIDEとクラウドスケール:データパイプラインを構築する最も生産的な方法—ローカルで開発・テストし、大規模なクラウドインフラにシームレスにスケールします。
- ゼロデータコピー、ゼロロックイン:データは独自のストレージに保持されます。DataChainはメタデータとバージョンのみを管理し、ベンダーロックインを防ぎ、コストを削減します。
- マルチモーダルデータ処理:ビデオ、PDF、音声、画像など、さまざまな非構造化データタイプをネイティブに処理・加工します。
- 大規模データ処理:数百万または数十億のファイルを効率的に処理し、MLモデルを使用してデータをフィルタリングし、データセットの更新を容易に計算するように設計されています。
- 再現性とデータリネージ:すべての依存関係を自動的に追跡して、データセットの任意のバージョンを再現し、ETLプロセスを介して自動的に更新します。
- 並列および分散処理:最新のクラウドインフラストラクチャを活用して、高速な並列データ処理を実現します。
DataChainの使用例
DataChainは多用途であり、幅広いAIおよびデータエンジニアリングの課題に適用できます。
- マルチモーダルモデルのファインチューニング:CLIPのようなモデルをファインチューニングして画像をテキストキャプションと一致させるために、複雑なデータセットを準備し、バージョン管理します。
- スケーラブルなドキュメント処理:数百万のドキュメント(例:PDF)からテキストを抽出・解析し、RAG(検索拡張生成)システム用のベクトル埋め込みを作成するパイプラインを構築します。
- コンピュータビジョン向け生成AI:生成コンピュータビジョンモデルのトレーニングと評価に必要な膨大なデータセットを作成、キュレーション、管理します。
- AIエージェントとコパイロットの強化:信頼性が高く、バージョン管理された構造化データを提供し、AIエージェントとコパイロットが正確で最新の情報で動作することを保証します。
- データキュレーションとフィルタリング:MLモデルを使用して、膨大な生データコレクションから最も価値のあるデータをプログラムでフィルタリング、ラベリング、選択します。
DataChainの利点
DataChainは、最新のAIシステムで作業するチームに明確な利点を提供します。
- 効率性:ゼロコピーアーキテクチャとスケーラブルな処理により、データ準備に関連する時間とコストが劇的に削減されます。
- 開発者中心:Pythonネイティブのアプローチは、参入障壁を下げ、開発チームの生産性を向上させます。
- 堅牢性と再現性:すべてのデータ作業がバージョン管理され、再現可能であることを保証し、これはエンタープライズグレードのAIアプリケーションにとって重要です。
- オープンソース基盤:強力なオープンソースコア上に構築されており、透明性、柔軟性、強力なコミュニティを提供します。
- 信頼できるチームから:MLOpsコミュニティで広く尊敬されているツールであるDVCの作成者によって開発され、MLにおけるデータ管理の課題に対する深い理解を保証します。
料金プラン
DataChainは、さまざまなニーズに合わせて柔軟な階層型料金モデルを提供しています。
- オープンソース:非構造化ストレージサポート、データバージョン管理とリネージ、セマンティック検索、Pythonパイプライン、並列処理などのすべてのコア機能を含む、無料のセルフホストプランです。テラバイト規模のデータと最大3000万アイテムに適しています。
- チーム(SaaS):チーム向けに設計されたマネージドクラウドサービスです。オープンソースのすべてに加えて、ペタバイト規模のデータ(10億以上のアイテム)、分散処理、自動スケーリング、Web UI付きの共有データセットレジストリ、SSO/SAML、RBACの機能が含まれます。価格については営業にお問い合わせください。
- エンタープライズ:特定のセキュリティおよびデプロイメント要件を持つ大企業向けです。このプランには、すべてのチーム機能に加えて、Bring Your Own Cloud(BYOC)およびオンプレミスデプロイメントのオプションが含まれます。価格については営業にお問い合わせください。
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 3.8K
- 2026-1: 5.3K
- 2026-2: 4.5K
- 2026-3: 6.0K
- 2026-4: 3.2K
- 2026-5: 4.4K
Geography
Top 5 countries / regions
- 🇺🇸アメリカ合衆国52.3%
- 🇷🇺ロシア19.7%
- 🇮🇳インド13.2%
- 🇩🇪ドイツ12.2%
- 🇪🇸スペイン2.6%
Top keywords
| Keyword | Cost per click |
|---|---|
| chemin ai | $0.00 |
| claude structured output | $0.00 |
| data chain | $0.00 |
| datachain | $0.00 |
| unstructured io | $1.63 |
DataChain Alternatives
DataChain Categories
DataChain Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools

Dagster
Dagsterは、AIおよびデータパイプラインの構築、スケーリング、監視のために設計された、現代的なオープンソースのデータオーケストレーターです。統一されたコントロールプレーンとして機能し、チームがデータアセットのモデル化、リネージの追跡、データ品質の確保を自信を持って行えるようにします。ローカルテストや再利用可能なコンポーネントといったソフトウェアエンジニアリングのベストプラクティスを統合することで、データエンジニアやMLチームがより迅速かつ確実に製品をリリースできるよう支援します。
機械学習オペレーション
Flyte
Flyteは、本番環境グレードのデータ、機械学習、分析パイプラインを構築、デプロイ、管理するために設計された、オープンソースのクラウドネイティブなワークフローオーケストレーションプラットフォームです。スケーラビリティ、再現性、使いやすさを重視しており、チームがローカル開発から大規模な本番環境へシームレスに移行できるようにします。PythonファーストのSDKと多言語サポートにより、Flyteはデータサイエンティストやエンジニアが複雑でバージョン管理された、保守性の高いワークフローを作成することを可能にします。
MLOps
Union.ai
Union.aiは、複雑なAIおよび機械学習ワークフローをオーケストレーションするための、エンタープライズグレードの本番環境対応プラットフォームです。オープンソースのFlyteを基盤とし、チームが比類のないパフォーマンスと効率で複合AIシステムを構築、提供、拡張できるよう支援します。データとMLのギャップを埋め、「スケール・トゥ・ゼロ」などの機能でクラウドコストを最適化し、シームレスな統合エクスペリエンスを通じて開発者のベロシティを向上させます。
オーケストレーション

deepchecks
Deepchecksは、LLMベースのアプリケーションを評価、検証、監視するためのエンドツーエンドのプラットフォームです。AIチームがAIの進捗を定義、測定、検証するのを支援し、開発からCI/CD、本番環境までのテストを合理化することで、高品質で信頼性の高いアプリケーションのリリースを保証します。
分析
DataChain Comments (0)
Sign in to comment.
ログインNo comments yet.